
迈向通用型AI第一步,OpenAI打造特殊ML量化指标训练平台,要来修正过度学习的AI难题
OpenAI
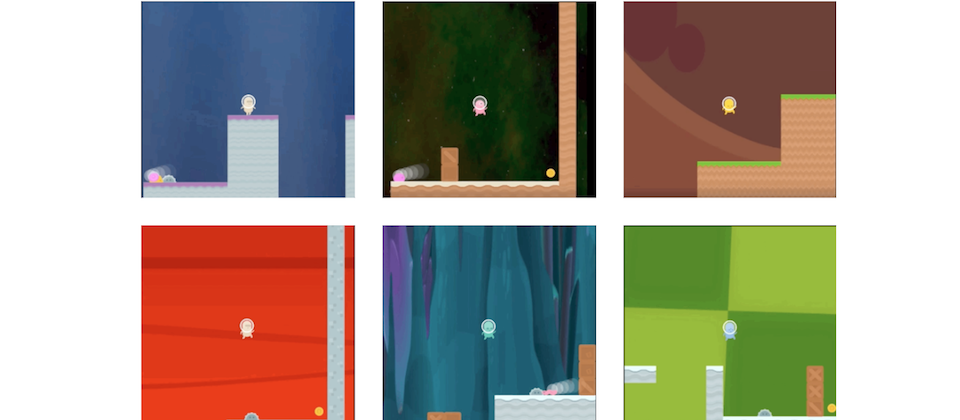
OpenAI近日释出一个特别的训练环境CoinRun,该平台借由游戏设计,能够提供关键的量化指标,让程式将过去学习到的经验,转移到全新环境中,也解决了强化学习长久以来的难题,CoinRun的环境比起传统的游戏平台简单许多,像是音速小子(Sonic the Hedgehog),但是却保有丰富且广泛的挑战,提供给最新的算法程式来解决。
打造出适用于不同任务的通用模型,对现今的深度强化学习算法,还是一大难题,虽然受过训练的程式可以解决复杂的任务,但是换到新的环境时,该程式就会面临转移经验的挑战,尤其强化学习程式常常会有过度学习(overfittng)的问题,模型学习成果贴近训练资料,换成别的测试资料效果就会大打折扣,无法学习到通用的技能。
CoinRun模仿音速小子游戏平台,设计成让现有的算法容易被训练的环境,提供可量化的大量训练资料,CoinRun每个关卡的目标即是在有障碍物的环境中,收集硬币,如果程式代理人撞到障碍物,在游戏中就会死亡,唯一的奖励机制是收集硬币,且这项奖励机制是固定的,若程市代理人死亡、集满硬币,或是移动1,000步之后,该游戏关卡就会结束。
为了评估该模型的通用程度,OpenAI用常见的3层式卷捷豹构,OpenAI也称之为Nature-CNN,训练了9个程式代理人在CoinRun平台玩游戏,其中8个程式代理人在第100~16,000关卡中训练,另外一个程式代理人的训练,则是不限制任何关卡,因此,该程式代理人便不会看见同一个关卡两次,每个关卡对该代理人而言,都是全新的环境,程式代理人是透过近端策略最佳化(Proximal Policy Optimization,PPO)算法来训练,在固定关卡学习的程式,每个关卡会玩成千上万次,而不固定训练关卡的程式,每个关卡只会玩一次。
OpenAI收集了单独训练的AI程式表现结果,在少于4,000个关卡的训练配置中,该程式出现过度学习的问题,超过16,000个关卡,问题依旧存在,接着,OpenAI利用CoinRun固定的500个关卡来训练AI程式,发现透过多项正规化技术,可以改善训练结果,像是Dropout和L2正规化、资料扩增和环境随机性。
除此之外,OpenAI也开发了另外2个环境来研究过度学习的问题,分别是CoinRun的变化版CoinRun-Platforms和简单迷宫导航环境RandomMazes,在这些实验中,研究人员采用原本的IMPALA-CNN架构,透过长短期记忆模型(long short-term memory,LSTM)来进行实验,在CoinRun-Platforms的环境中,AI程式要在1,000步的时间限制内收集硬币,硬币随机分散在不同的关卡中,因此,程式必须积积极探索。
OpenAI表示,该研究成果提供打造强化学习通用模型更多研究方向,透过CoinRun环境,精准地量化过度学习的问题,有了这项指标后,研究人员可以更准确地评估,要用哪个架构和算法,OpenAI也提出几个建议的未来研究方向,像是研究环境复杂度和关卡数的关系、重复的架构对通用型AI是否合适、探索多种正规化组合最有效的方法。



