英伟达开放Vera Rubin机柜设计
AI 工厂越建越大,单打独斗的封闭设计越来越跟不上交付速度。在圣何塞开幕的 OCP(开放计算项目)全球峰会上,英伟达宣布把下一代 Vera Rubin 平台的机柜与计算托盘关键设计,通过开放的 MGX 架构贡献给 OCP,让系统厂商有统一蓝图去规划下一代 AI 数据中心的机柜、网络、供电和散热。
更新的 MGX 1.2 规格带来了几项关键变化:机架级盲插液冷(计算托盘推入机柜时液冷接口自动对接,省去逐一手动接管路)、面向更高功率系统的 5000 安培液冷母排,以及最高 250 千瓦的机柜部署能力;同时原生支持 19 英寸设备,加入可配置 I/O 舱、无风扇液冷计算托盘和标准化的供电散热接口。英伟达称这些改进能明显缩短装配、测试和现场维护时间。
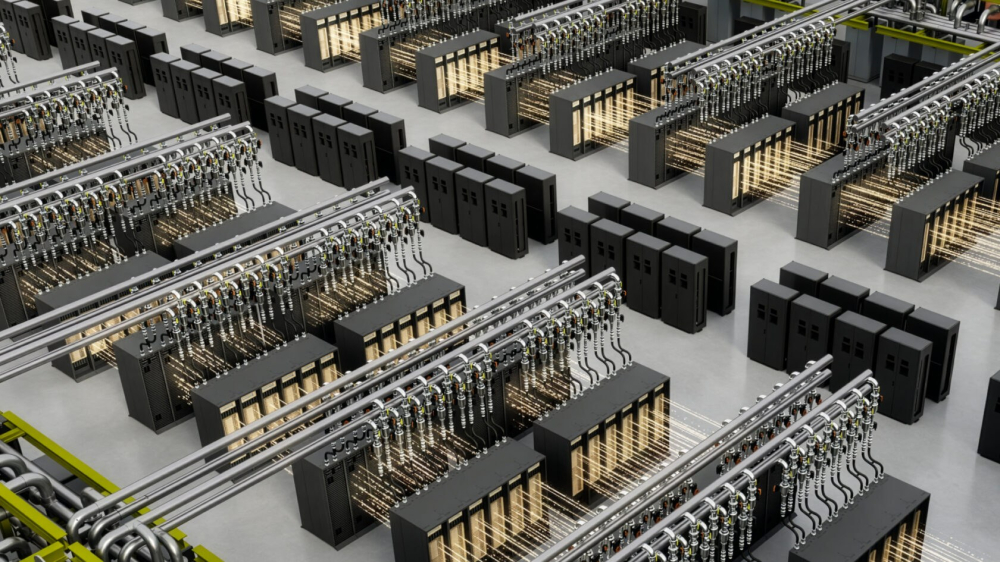
英伟达还公布了 Vera CPU 机柜设计规范,把 MGX 架构从加速计算延伸到智能体 AI 时代:与承担大规模训练推理的 Vera Rubin NVL72 不同,Vera CPU 机柜专门面向工具调用、任务编排和沙盒执行等智能体日常运行所需的计算设施。软件侧,DSX AI 工厂平台新增了交换机自动配置、GPU 集群压力测试、机柜管理等开源组件,宣称能把裸机变成生产集群的时间从数天压缩到数小时。
开放标准方面,英伟达与 AMD、谷歌、Meta 联合发布了开放数据中心规范 v0.7,统一下一代 AI 工厂的供电架构、散热设施和物理布局;与谷歌、Meta、微软共同发布的电网韧性规范,则要求大型 AI 设施在电网扰动期间保持连接、自动响应,并在两秒内恢复到接近满载运行。
网络侧的生态进展同样密集:Meta 宣布采用英伟达 Spectrum-6 102.4T 以太网交换机,其自研 N-IceCube 交换机将运行开源 FBOSS 网络操作系统,配合 Multiplane 多平面技术支撑超过 10 万块 GPU 的智能体 AI 工厂;谷歌的 Falcon 传输协议未来将登陆英伟达 ConnectX-10 SuperNIC 与 BlueField DPU,让两家网卡通过通用传输层互通。鸿海旗下 Visionbay 也公布了基于英伟达 800V 直流参考架构的 AI 工厂设计。
最受关注的一项是与思科联合推出的 USFP(超密小型可插拔)光模块规范:业界首个面向 400Gb/s 单通道电信号的模块形态,在 OSFP 同尺寸封装内起步 16 个全双工通道(6.4Tb/s),未来可扩展至 32 通道、12.8Tb/s,相比现有 200G 单通道模块带宽密度提升 4 倍、每比特功耗效率提升约 1.3 倍,并采用两步插拔的二维阵列连接器设计。TE Connectivity 与安费诺将参与共建多源硬件生态。对数据中心运营商而言,这意味着不用增加网络层级、不换机柜,就能把 AI 工厂继续往大了接。
编译自 NVIDIA 官方博客,原标题:"Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide"