英特尔推理GPU定名D系列 单卡480GB显存
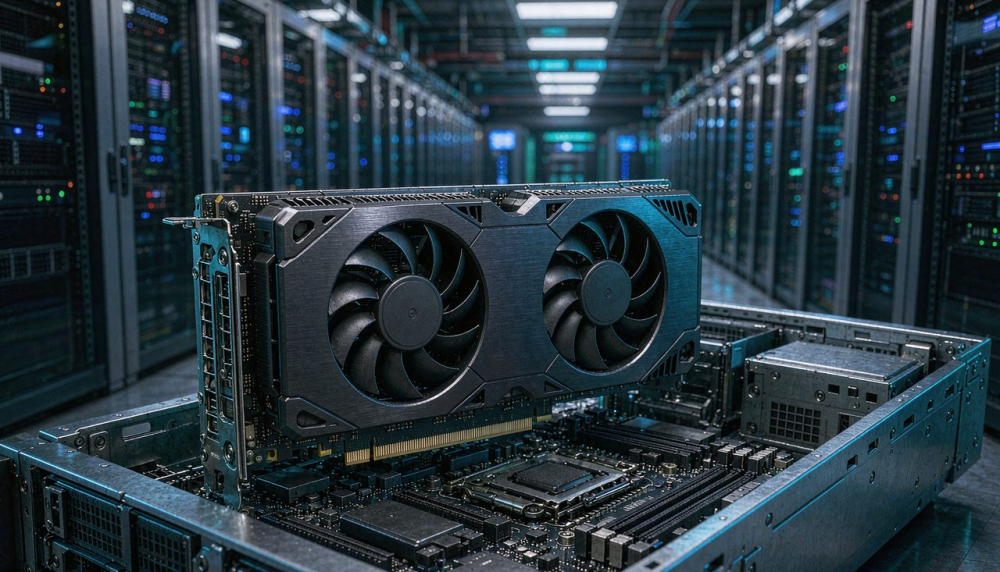
在OCP全球峰会上,英特尔披露了此前代号"Crescent Island"(新月岛)的AI加速卡的正式名称——英特尔GPU D系列,并首次给出关键规格:基于全新Xe3P架构,搭载最高480GB LPDDR5X显存、1.5TB/s显存带宽,FP8算力1.3 PFLOPS,功耗控制在350瓦以内,采用标准PCIe外形、支持风冷。
英特尔强调,D系列的定位是改善"持续、显存密集型AI推理"的经济性:单卡可运行3000亿参数的模型,8卡系统可承载超过1万亿参数。目标场景包括多租户AI服务、机器人以及其它时延敏感型业务。目前样品已开始向客户送测,但公司没有给出正式上市时间。
换个参照系,这个性能档位相当克制:英伟达Vera Rubin NVL72机柜里的每颗GPU标称FP8算力17.5 PFLOPS,并且需要液冷。D系列走的是另一条路——不追求单卡极限算力,而是用大显存、低功耗加标准风冷机柜,把推理部署门槛降下来。
英特尔数据中心系统与解决方案集团企业副总裁尼古拉·迪贝(Nicolas Dubé)表示,开放模型正在扩大企业的部署选择,而要发挥其潜力,"组织需要能把不同工作负载与合适的智能、算力和经济性相匹配的基础设施",他称之为"把每个提示词放到该去的地方"。
通用计算侧,英特尔也给出了新的机架级方案:部分Xeon 6+配置可在133.45千瓦整机柜功耗下扩展到超过46000个核心,用于支撑代理式AI工作流中的任务编排、数据处理与工具执行。
对英特尔而言,D系列是其在数据中心GPU屡屡受挫后的又一次押注——此前的数据中心GPU Max家族(代号Ponte Vecchio)未能打开市场。能否在推理这条细分赛道上真正站稳,还要看软件栈与生态的成色。
编译自 Intel Newsroom,原标题:"Intel Accelerates Open Infrastructure for the Agentic AI Era"