英伟达开源Kumo Tabular表格大模型
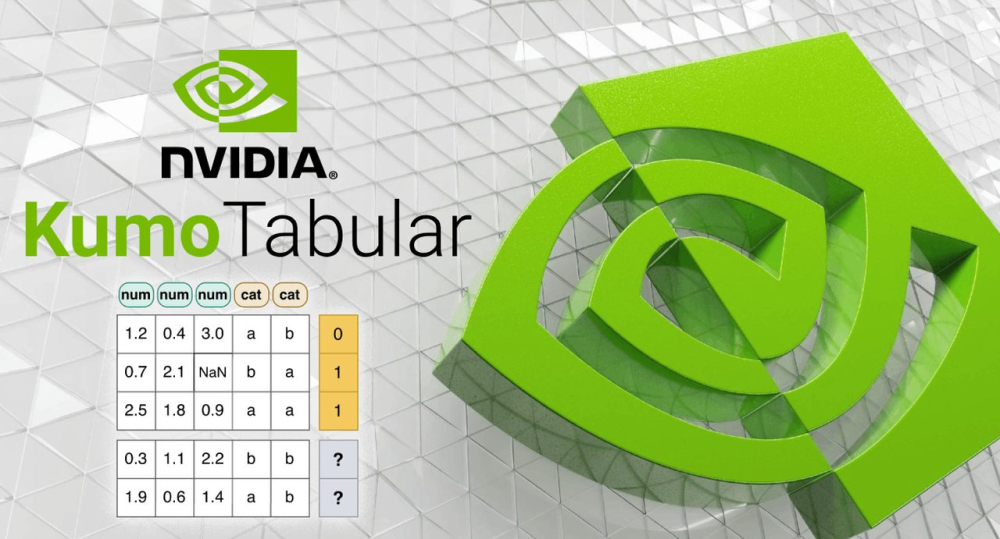
在企业数据分析的世界里,被预测的往往不是图片和文字,而是表格:客户会不会流失、这笔贷款会不会违约、下个季度需求有多少。几十年来,干这些活的一直是梯度提升树——每换一个数据集、每换一个问题,就得重新做特征工程、重新训练一轮。现在英伟达想用大模型的玩法改掉这件事:9月29日,英伟达正式开源表格基础模型 Kumo Tabular。
Kumo Tabular 的核心思路是「上下文学习」:把带标签的表格行当作提示词读进去,然后对新行做一次前向传播,直接输出分类概率或回归分位数——不用训练、不用调参、不用为每个任务单独建模。小、中、大三个版本参数量从 2800 万到 2.15 亿,靠着这一手,它在表格学习权威榜单 TabArena 上以 1950 ELO 拿下总榜第一,且在统一评测环境下速度最高达到基线模型 LimiX-2 的 17 倍。
更特别的是它的「出身」:这个模型完全没有见过一张真实表格。英伟达用结构因果模型生成数千万张带缺失值、异常值和各种脏数据的人造表格来预训练,让模型学会「读表」这件事本身,而不是记住某个领域的数据分布。文本、图片、时间戳列可以通过内置预处理方案转换后输入;单次前向最多处理 10 个类别,更多类别由纠错输出码扩展。
当然,英伟达也把丑话说在前面:当数据分布偏离训练范围太远时精度可能下降,部署前仍需在留出数据上验证准确性与校准度。目前权重已以允许商用的 OpenMDW-1.1 协议上线 Hugging Face,配套开源推理库同步发布,训练配方与合成数据生成器稍后公开。对被 GBDT 统治了几十年的表格预测赛道来说,一个「免训练」时代可能正拉开序幕。
编译自 NVIDIA(Hugging Face 官方博客),原标题:"NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier for Tabular Prediction"