谷歌提出RRSI方法 给自我改进智能体踩刹车
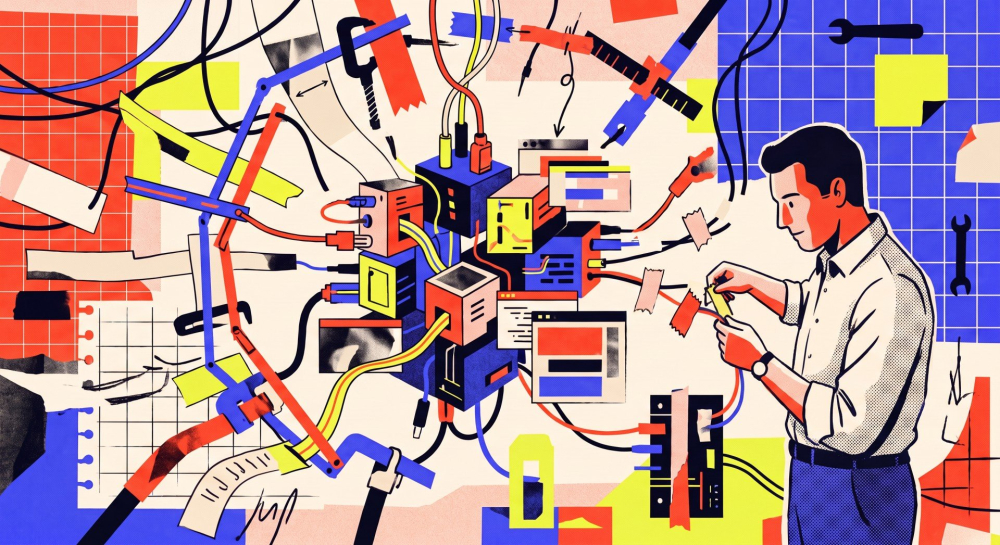
现代AI智能体的能力,很大程度上取决于包裹在模型外面的一层「线束」(harness):提示词、工作流、工具、记忆和逻辑共同决定模型每一步看到什么、出错后如何恢复。谷歌研究者在论文中指出,近期智能体的进步大多来自对线束的打磨,而非模型本身的升级。
过去打磨线束靠人工复盘失败案例,如今更流行让大模型根据测试反馈反复改写线束——研究者称之为一种「实用形态的递归自我改进」。但这带来一个隐患:智能体反复面对同一小批测试任务,会把任务背下来。训练分数节节攀升,遇到没见过的新任务却几乎原地踏步,甚至出现只适配某个基准的套路、靠运气得分、以及堆砌无用复杂度「刷分」等过拟合行为。
谷歌云AI研究团队与合作高校在论文中提出RRSI(正则化递归自我改进),在优化闭环的两端同时设限。每次改动有预算上限,且预算随时间收缩:早期允许大改,后期只接受能明确归因的小改动;系统还会记录历史尝试,避免反复掉进同一个坑,进展停滞时则主动去探索线束中从未动过的部分。
审查环节同样设卡:一个「批评者」模型会否决任何硬编码任务名、答案或基准专属技巧的提案;只有可量化的性能提升才配得上更高的算力开销,不再起作用的组件会被删除。整个过程中线束保持完全可编辑,模型权重始终冻结。
研究团队在覆盖编程、智能体办公、工程设计的8个基准上做了对比,底座模型为Claude Opus 4.8。RRSI在训练任务上最多提升14.1分,在5个从未见过的基准上最多提升4.7分(JobBench),运行时token消耗比未加正则的版本少约三成。其他方法在训练集上更强,换到新任务却普遍「翻车」,有两种甚至跌破基线——这正是护栏带来的取舍。
泛化能力也有交叉验证:用Gemini 3.5 Flash优化出的线束,直接套在弱得多的Gemini 3.1 Flash Lite上,把后者的成绩从11.2提到14.6,说明找到的机制并不依赖发现它的那个模型。论文同时引用了反面教材:为ARC-AGI-3手工设计的线束在熟悉环境拿下97.1%,陌生环境直接归零。代码已在GitHub开源。
编译自The Decoder,原标题:"Google researchers find a way to keep self-improving AI agents from memorizing their tests"