Sakana新框架 模型自己组队教自己
东京AI初创公司Sakana AI于10月11日发布新研究MASS(多智能体自监督),试图回答一个此前一直没有好答案的问题:当模型要做的是人类也没做过的发现、连专家都难以评判时,谁来监督它自己?论文给出的方案听起来有点反直觉——让模型自己组队,再从整个团队的经验里学习。
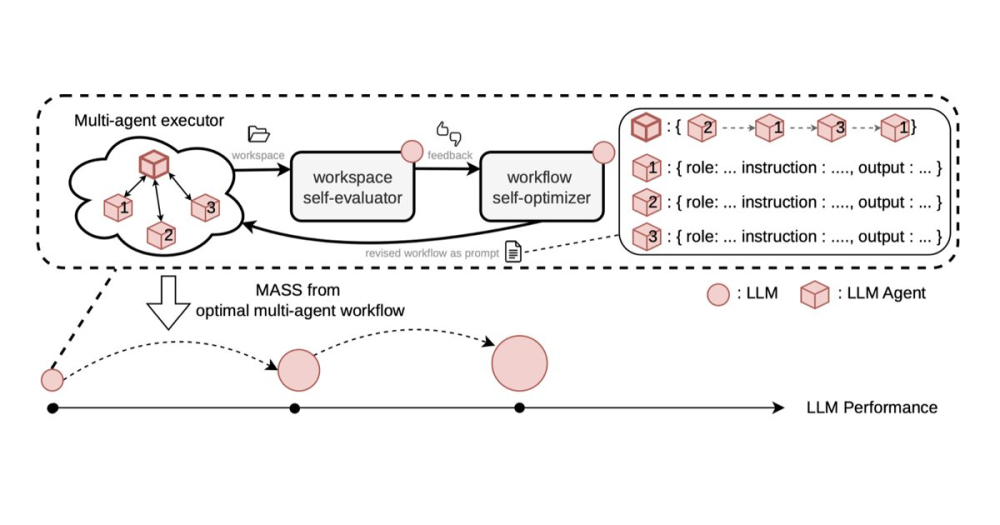
整个系统自始至终只有同一个27B开源权重模型,但它分饰三个角色:执行者带着一群子智能体干活,产出包含代码、图表和报告的完整工作空间;优化者不干活,专门修改「团队怎么协作」的流程文档;评估者则把两个工作空间摆在一起,判断哪个完成得更好,并给出理由。
关键设计是把「团队怎么干活」拆成角色、指令、契约和调用顺序四个组件。模型先用评估反馈把多智能体工作流搜到最优,再把冠军团队的执行轨迹蒸馏回模型权重,作为下一轮的起点。循环两轮之后,在四个研究型基准上,每token得分达到未改动基线的1.2至1.6倍,其中MLR-Bench最高达1.60倍;与基线正面对比的胜率也从一轮后的53.9%升到两轮后的69.9%。
效率上同样有交代:多智能体方案用2880万监督token拿到68.3%的胜率,而单智能体方案需要4200万token,相当于少用了31%的训练数据。不过这套流程并非全面碾压——在代码为主的SWE-bench Verified和Terminal-Bench 2.0上,同一个系统反而退步到基线的0.94倍和0.96倍。
作者把论文里最大的问题写在了明面上:在这种「自己当裁判」的同构回路里,一个共享盲区可能让有缺陷的结果被当作进步接受,进而被训练固化。论文把这一风险称为递归自改进的「阿喀琉斯之踵」,并呼吁社区在推进这类方法时,同步研究如何保留可被人类检测和干预的监控手段。
这项工作由加州大学伯克利分校的Hyunin Lee、Donghyun Lee、Somayeh Sojoudi、Matei Zaharia与Sakana AI的Jinglue Xu、Jeffrey Seely、Yujin Tang共同完成,论文与代码均已公开。MASS上线后在Hacker News引发不少讨论,不少研究者认为,「模型既是选手又是评委」带来的安全问题,比跑分本身更值得关注。
编译自 Sakana AI,原标题:"MASS: Recursive Self-Improvement through Multi-Agent Self-Supervision"