Meta揭秘百万GPU超级集群Prometheus
报价宝综合消息Meta揭秘百万GPU超级集群Prometheus
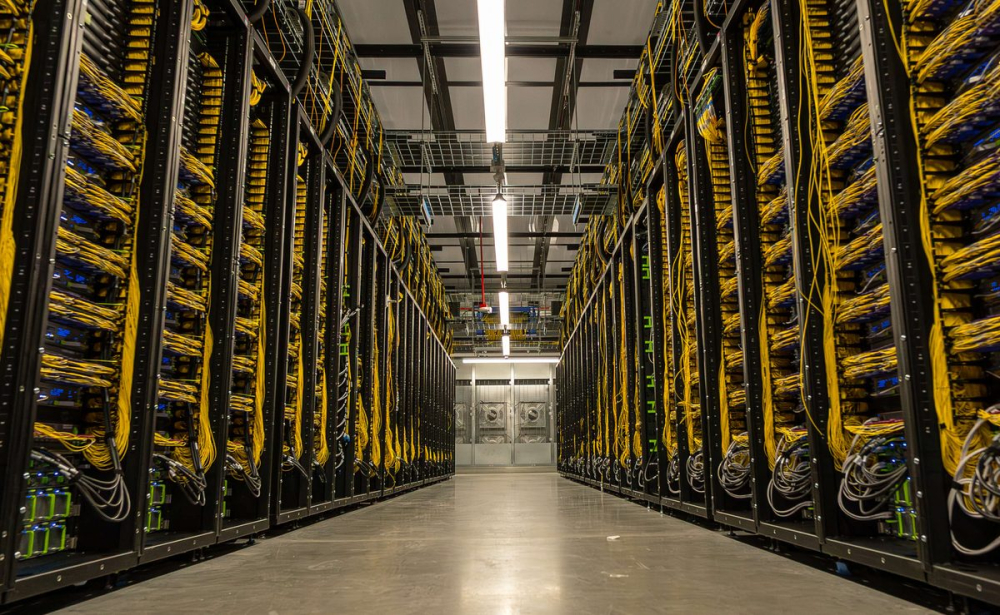
美国时间10月19日,Meta在官方工程博客首次完整披露了其位于俄亥俄州纽奥尔巴尼(New Albany)数据中心的Prometheus超级集群。这座吉瓦级集群由多栋楼宇通过数英里光纤互联组成,对外表现为一台"单一机器",目前已有数十万块GPU在线,全部建成后预计容纳约100万块分布式GPU同步运转。
Prometheus已经承担了Meta超级智能实验室新一代模型Muse Wonder的训练。官方数据显示,其预训练任务的有效算力占比(goodput)超过85%,强化学习阶段超过90%;训练平均无中断时间约4.7万GPU小时,经过固件修复等措施已提升到5.4万GPU小时以上。
硬件上,Prometheus现役部署两代英伟达平台。第一代"卡塔利娜"(Catalina)基于GB200 NVL72的Ariel双机柜配置,每块GPU配备800G对外带宽和192GB HBM3e显存,双机柜合计13.4TB显存、720 PFLOPS FP8算力。第二代"克莱门特"(Clemente)升级到GB300 NVL72,单机柜即可装下全部72块GPU,单卡显存提升至288GB,FP4峰值算力超过1 exaFLOP,整机柜功耗约135千瓦。
Meta还预告,第三代基于英伟达Vera Rubin NVL72的平台即将上线。官方表示,Prometheus的目标很明确:为下一代前沿模型提供更大的模型规模和更长的上下文窗口,并将继续扩容。
在白热化的AI基础设施竞赛中,吉瓦级集群正成为头部实验室的标配。Meta选择公开这座集群的工程细节,被外界视为对自家超级智能实验室模型路线图的一次背书。