会聊DNA的开源模型来了 笔记本就能跑
AI开放平台Hugging Face周四发布一款全新的开源生物模型Carbon-X,它既能读懂DNA序列,也能理解自然语言,而且小到可以在一台普通笔记本上本地运行。研究团队希望它帮助科学家设计新药和基因疗法,甚至帮普通人理解自己的基因组。
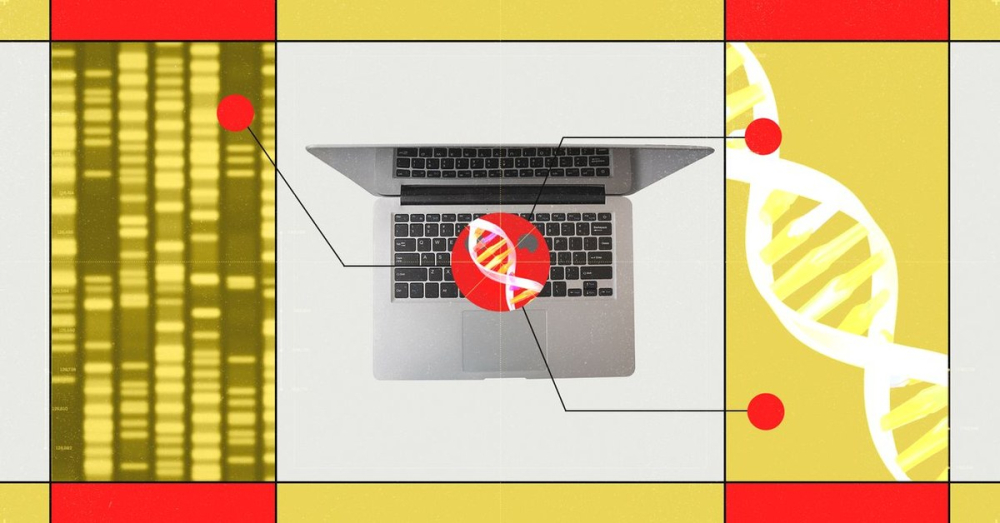
该模型由Hugging Face与中国中关村学院、意大利那不勒斯费德里科二世大学的研究人员联合开发,训练数据混合了基因组序列和自然语言。用户可以直接用日常语言提问,例如某个DNA变化会如何影响基因活性与健康,模型会给出对话式回答。Hugging Face资深研究科学家路易斯·滕斯托尔说,这解锁了语言模型的一项全新能力,本质上就是能与DNA对话,非技术背景的用户也能问出其他工具无法回答的问题。
Hugging Face被称为AI界的GitHub,今年9月英伟达已同意以近130亿美元将其收入麾下。DNA用四种碱基字母编码信息,一份人类基因组包含60亿个字母,虽然早已完成端到端测序,但科学家至今仍不清楚其中大部分序列的作用。此前谷歌DeepMind的AlphaGenome能预测DNA序列和突变的影响,但输出数值格式且更吃算力;Arc研究所与英伟达等开发的Evo 2则能用DNA语言从头生成完整基因组。Carbon-X把两者结合成一个对话界面,团队形容它就像DNA版ChatGPT。
训练方法上,团队从现有语言模型出发,把词表扩展到按六个字母一组读取DNA,随后用3000亿token继续训练,数据混合了DNA序列、英文文本以及把DNA与生物学描述关联起来的样本。序列覆盖哺乳动物(包括人类)、其他脊椎动物、无脊椎动物、植物、真菌和原生生物。团队刻意没有纳入病毒序列,以防模型被用于危险用途。
安全设计上也有取舍:用户无法上传完整人类基因组,单次只能查询约5万个碱基对的片段。模型参数量被刻意控制在140亿,就是为了能在用户本机运行,研究者常因合规限制无法把患者敏感数据传给云端大模型,而Carbon-X不向Hugging Face或任何公司发送数据。滕斯托尔同时提醒,团队尚未用真实湿实验验证过模型,其预测准确性还无法给出量化结论。
编译自 WIRED,原标题:"Hugging Face's New AI Biology Model Lets You Chat With DNA"