Hugging Face开源DNA对话模型
AI开源平台Hugging Face于美东时间10月22日发布了一个面向生物学的大模型Carbon-X:它能用自然语言「和DNA对话」,而且小到可以在一台笔记本上本地运行。研究者只需贴入一段DNA序列,再用大白话提问,就能得到关于这段序列的对话式解答。
该模型由Hugging Face与中关村学院、意大利那不勒斯费德里科二世大学的研究者合作开发,训练目标是让模型理解基因突变对基因活性与健康的影响。团队中的高级研究科学家滕斯托尔表示,这意味着非技术背景的用户也能提出过去只有专业工具才能回答的DNA问题,长期看既可用于新药和基因疗法设计,也可能帮普通人解读自己的基因组。
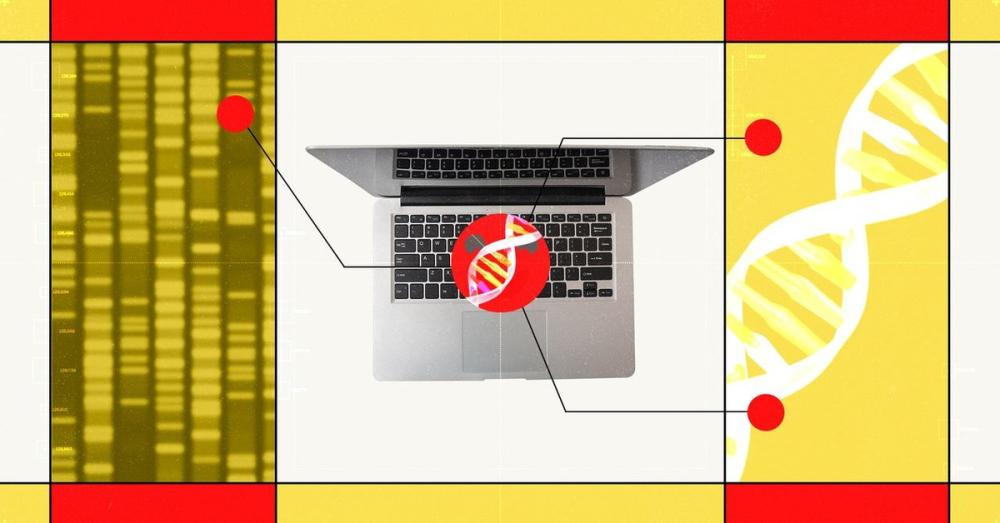
技术路线上,团队在现有语言模型的基础上扩充词表,让模型按每六个字母一组读取DNA,再用3000亿token的混合数据继续训练,语料把DNA序列、英文文本和序列与生物学描述的对应关系揉在一起。训练数据覆盖哺乳动物、其他脊椎动物、无脊椎动物、植物、真菌和原生生物,但刻意没有纳入病毒序列,以避免模型被用于危险用途。模型单次只能处理约5万碱基对,无法上传完整人类基因组。
把参数刻意控制在140亿,还有隐私上的考虑:研究者上传可识别的敏感患者数据到云端大模型往往受合规限制,而Carbon-X可以直接在用户自己的硬件上运行,数据不经过任何公司服务器。一个典型场景是判断某个基因突变究竟良性还是致病——这是研发靶向药和基因疗法时绕不开的第一步。
不过团队也坦承,模型尚未经过湿实验验证,预测准确率还无法给出结论。这个赛道竞争者不少:谷歌DeepMind的AlphaGenome能预测DNA序列和突变影响但输出数值结果,Arc研究所与英伟达的Evo 2则能从零生成完整基因组,Carbon-X的差异化在于把DNA和自然语言装进了同一个对话界面。
被称为「AI界GitHub」的Hugging Face近况也不错:今年9月,英伟达宣布以接近130亿美元的价格收购该公司。
编译自 WIRED,原标题:"Hugging Face's New AI Biology Model Lets You Chat With DNA"