开源模块让RTX 30系BF16提速八成
一个名为 GPU unlock 的开源项目这两日在技术社区走红:它用一个 Linux 内核模块,把 NVIDIA RTX 30 系显卡的 FP 与 BF16 指令发射速率解锁到同代专业卡的水平,用户实测在部分矩阵运算上快了七成到八成。
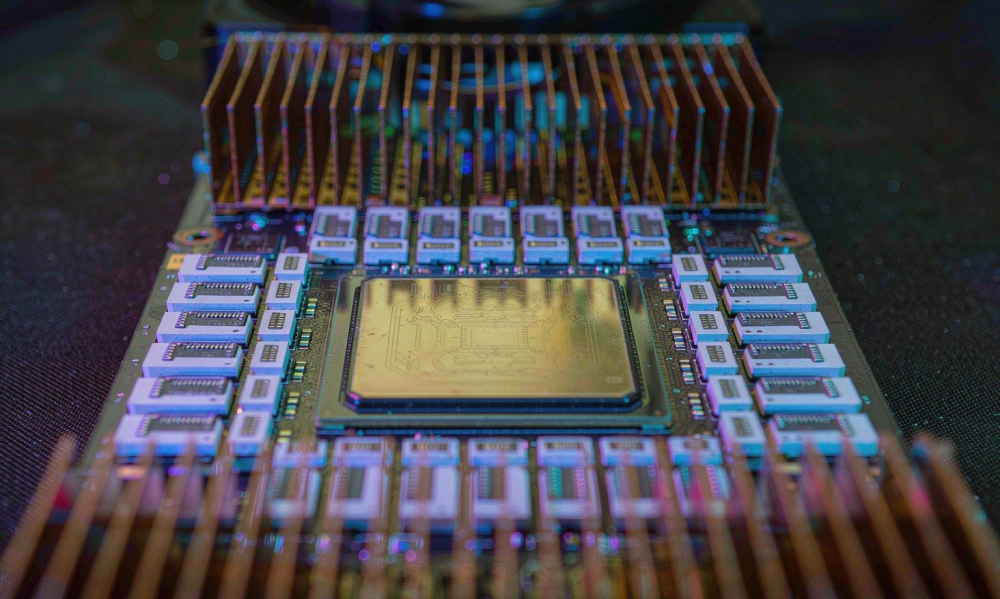
原理不算复杂,但动手的位置很讲究。GA102、GA103、GA104、GA106(即 RTX 30 系桌面卡)在硅片上具备完整的 BF16 吞吐,出厂固件却把速度选择器写在了半速档。项目沿用了矿卡解锁的思路,也就是 V67/PLM 那一套手法,同时借用了 UEFI 方案「在驱动之前动手」的时序:内核模块在 initramfs 阶段先于 NVIDIA 驱动绑定显卡,写入速度选择器 SS0 = 0x88888888(对应全速 BF16)和四位的 SS1 = 0x8(IMLA4),再触发一次 FLR 复位。
好处是不用刷 BIOS,也不是给驱动打补丁,NVIDIA 之后每次更新驱动都不必重新适配。代价是要在内核命令行里显式开启,写 gpu_unlock.targets=all 或指定具体 PCI 地址,安装时模块会被塞进 initramfs;不支持休眠,挂起恢复后模块会再解锁一遍,大约多花一秒钟,多卡与直通给虚拟机的卡同样有效。
数据来自用户提交的报告。一张 450 瓦的 3090 Ti 跑 8192 立方的稠密 GEMM、FP32 累加,五次取样中位数:FP16 从 87.46 涨到 118.39 TFLOPS,BF16 从 87.50 涨到 157.41,TF32 从 42.58 涨到 82.61。其他卡型的 BF16 矩阵运算提升区间大致是:3090 两成五到六成七,3080 约七成,3070 七成三到八成,3060 约八成。也有反例——3080 Ti 20GB 的 OEM 版本解锁能跑通,BF16 却仍是半速,项目维护者把它如实记在了兼容性表格里。
收益并不均匀。真正受益的是算力受限的负载:大模型 prefill 提升一成四到三成六,扩散模型与 FlashAttention 同步变快;而受显存带宽限制的 LLM decode,以及走 INT8 的通路基本没动静。多份对比报告称解锁前后的输出逐位一致,说明改的只是发射速率,没有动数值路径。
为什么这件事值得写:二手 3090 是眼下本地跑推理最常见的硬件之一,一张卡凭空多出大半截矩阵算力,等于把「每美元算力」这条曲线重新画了一遍。它同时也提醒人们,消费卡与专业卡之间的差距,有一部分并不在硅片上,而是藏在固件里的几个寄存器。项目本身以 GPL-2.0 发布,但生成的固件源自 CMP 参考实现,NVIDIA 固件仍适用其自有条款,官方不提供任何支持——动手之前请自行评估风险。
编译自 GitHub,原标题:"GPU unlock 1.0.0 — Unlock FP/BF16 instruction issue rate on Nvidia 3000’s cards to their professional equivalents"