开发者把CPU塞进Qwen模型 算数不再靠外挂
大模型做不好算术怎么办?多数方案是让模型调用Python解释器或计算器等外部工具。开发者Divyansh Agrawal则给出了一个更极端的答案:他于10月下旬发布实验性开源模型Qwenputer,基于阿里Qwen3.5-4B构建,把一颗32位RISC-V CPU连同内存直接做进了神经网络权重,让模型不依赖任何外部工具也能执行程序和精确计算。项目已在Hugging Face和GitHub开源。
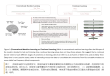
原理上,传统大模型靠预测下一个词元生成回答,遇到大整数乘除、长链运算时极易出错。Qwenputer的思路是把RISC-V的RV32IM指令集编译进模型权重,并利用Qwen3.5门控DeltaNet层的内部状态充当RAM:开发者锁定了两个关键设置,使状态中的每次写入都精确保留、按行寻址读取,从而把神经网络状态变成可用的内存。整个过程无需训练,由编译器直接算出所需权重写入,新增的11层插在原模型32层之前,原有权重保持不变。
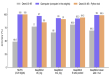
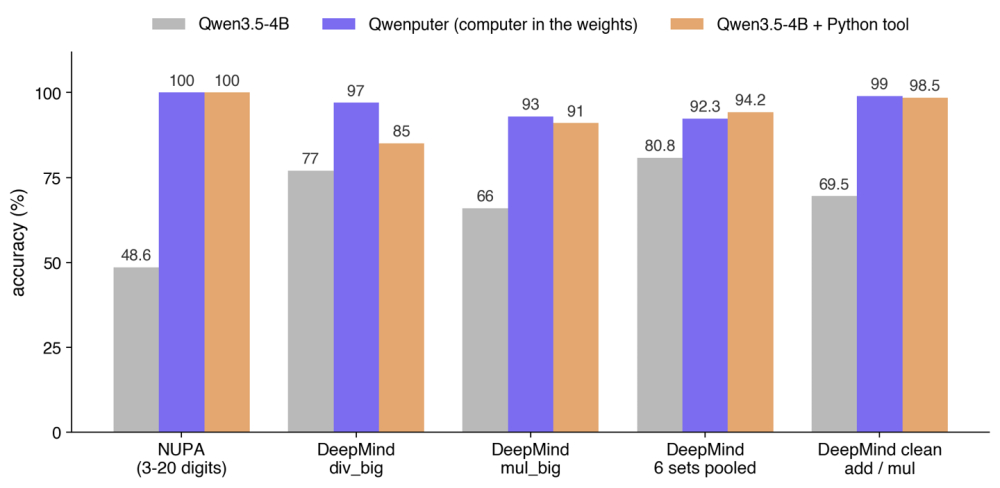
据开发者自报的测试结果,在大整数乘法上原版Qwen3.5-4B准确率约为五成五,Qwenputer提升到九成七五;大整数除法从七成二五升至九成七五;长整数运算基准NUPA则从不足五成跃升至满分。这颗CPU通过了RISC-V官方测试套件,连续执行约1800万条指令未出现错误。
项目还实验性地加入了模型内文件系统,最多可在状态中保存512个文件、约5.3万词元,并在后续对话中加载:跨对话记忆测试的问答准确率达九成,而直接把旧对话贴回上下文的对照方式仅三成。代价同样明显:模型体积增至约18.8GB、接近原版两倍,每条CPU指令需生成多个词元,原本毫秒级的计算可能耗时数秒,且需要专用驱动启动,运行环境为单张24GB显存的GPU。
需要指出,上述数据均为开发者自报,目前尚无独立第三方复现,但代码与权重完全开源、可自行验证。有分析认为,把确定性计算写进模型权重的能力,未来或许还能用于内置无法关闭的安全监控模块等方向。
编译自 IT之家,原标题:「Qwenputer 问世:把 RISC-V CPU 指令集塞进模型,AI 算数不再靠外部工具」