斯坦福研究:44%的大模型结论已过期
斯坦福大学研究者 Owen Queen 与 James Zou 把50条被广泛引用的大模型结论,放到20个模型上重做了一遍,结果是44%的结论已经“过期”。在有明确失效时间的22条结论里,平均寿命只有15.7个月。
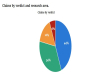
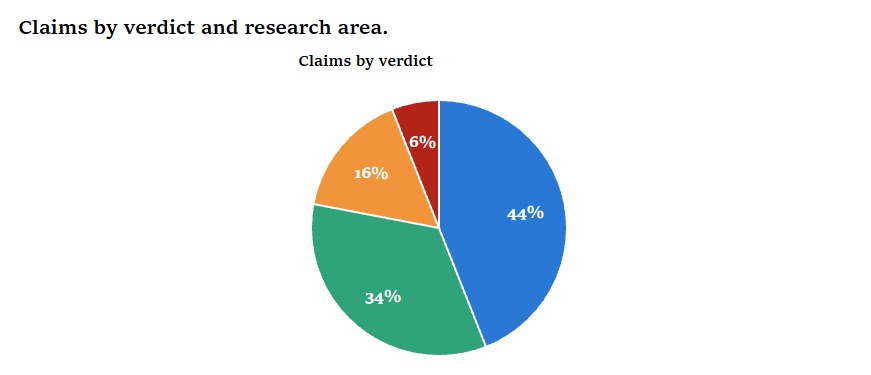
这轮复核使用的模型来自8家开发商,发布时间从2024年7月到2026年9月。原本的效果在多数结论中已明显消退:34%显著减弱,只有16%依然成立,还有6%反而变得更强。按时间看,一年后已有16%过期,两年后升到39%。
过期最快的是“模型做不到什么”这一类结论。9条与推理相关的发现里有5条被判过期,且没有一条保持住或变强,其中包括数“strawberry”里有几个字母、陌生进制下的算术、长上下文中间信息丢失,以及被用户质疑后就放弃正确答案。研究者推测,这类错误有明确的“正确结果”,开发者有清晰的优化目标。
关于偏好与行为倾向的结论活得更久。11条仍然成立或变强的结论中,3条涉及大模型当裁判时的偏差:偏爱自己的答案、给录用与拒稿论文打出相近分数、被医学摘要里的措辞带偏;另有3条涉及迎合用户。政治倾向偏左、开放式问题答案高度雷同、生成随机数时分布不均匀,这些现象也仍在。
论文造假引用被拿来做案例。2023年 Walters 与 Wilder 的研究中,GPT-3.5 编造了55%的参考文献;用同一批提示词测现在的模型,GPT-6.1 Sol 的编造率是0,Claude Sonnet 5.5 为1%,但同为2026年发布的 Qwen3.7-Flash 仍高达69%。
研究也提醒不要把结果读成“警报解除”。在需要组合两条已知事实的两跳问题上,Claude Sonnet 5.5 仍有约10%的情况答错,而它对两个单点问题都答对了,原始论文给 ChatGPT 的数字是43%。社会偏见则是混合图景:政治偏向仍在,性别刻板印象与内隐联想偏差减弱,针对非裔美国人英语使用者的偏差甚至在趋势数据里翻转了方向。
模型之间的差异同样很大。2026年7至9月发布的模型中,过期条数从 DeepSeek V4 Pro 的11条到 GPT-6.1 Sol 的30条不等,发布时间、开发商与模型规模都无法可靠预测这一结果。两位研究者因此建议,关于大模型的实证发现应被当作“特定模型在特定时点的观察”,而不是普遍真理;论文应记录模型版本与日期,并公开提示词与分析代码,以便在新模型上复测。
编译自 The Decoder,原标题:"Rapid LLM development is outrunning the research meant to explain it, study finds"