英伟达研究 短上下文顶住百万token任务
报价宝综合消息英伟达研究 短上下文顶住百万token任务大模型的上下文窗口越卷越长,从GPT-4发布时的8192个token一路涨到如今的百万级,足以一口气吞下一部《战争与和平》。但英伟达研究团队在arXiv上发布的论文直接把矛头对准这场军备竞赛,标题就叫《You don't need long context》——你不需要长上下文。 " />
这笔账算得明白:由于注意力要遍历缓存中全部历史token,长上下文下越靠后生成的token成本越高,在25.6万token窗口的末端,单token开销可达短窗口的7倍。研究团队的思路是“终末压缩”(EoCC):当历史接近预算上限,就让模型把它整理成结构化的状态摘要,丢掉原始流水账,带着笔记继续干活。更激进的单步压缩甚至要求每执行一步就压缩一次。
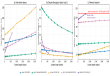
效果出乎意料。在SWE-bench Verified等软件工程基准上,Claude Opus 4.5全程保留历史的得分是70.0,每步压缩后反而升到70.2,峰值工作上下文中位数只有约8000个token;GPT 5.6 Sol从84.4小幅降到82.4。综合十几个长程任务测试,精度损失普遍在几个百分点以内,估算服务成本却只有保留全部历史的约七分之一到二分之一。
论文据此提出“语义状态空间模型”的构想:把长期状态存成外部结构化笔记,而不是无限膨胀的KV缓存。作者打了个比方——工程师写一天代码,并不会记住终端里滚过的每一行输出,靠的是任务清单和提交记录。不过研究也留了余地:整本小说的结构分析这类真需要通读全文的任务,长窗口仍有价值。真正的争议点在于,各家厂商仍把百万token窗口当作卖点,而英伟达的结论是:多数智能体场景下,那只是昂贵的冗余。
编译自 The Decoder,原标题:"Nvidia researchers argue huge AI context windows are a dead end"