AI从零设计出CPU 能效达4.59倍
报价宝 11月22日消息,帕洛阿尔托初创公司 Architect Labs 公布了一款名为 Frostbite 的通用处理器,称指令集与微架构全部由该公司的 AI 智能体自主发现、设计并验证,起点是「零架构先验」,人类只事先圈定了必须跑好的工作负载。
公司给出的成绩是:在25项工作负载上,由4个瓦片(tile)组成的 Frostbite 集群,每瓦性能是同规模、已流片的双发射顺序执行核心的4.59倍。这些数字来自7纳米工艺的仿真设计,芯片尚未流片,25项负载中有15项一直留到最终评测才启用。
它的出发点是对传统 CPU 的不满。现有处理器要靠硬件在运行时重新发现哪些指令彼此依赖,多核设计还得堆叠深缓存层级与一致性协议,面积和功耗代价都不小。Frostbite 走的是「免费多线程」:让程序自身把并行性暴露出来。程序被编译成 interaction nets——一种1990年提出的计算模型,程序是一张节点图,计算就是改写相连的节点对。被改写的节点对永不重叠,因此可以任意顺序执行,也可以同时执行,结果一致;每个值只被使用一次。团队举的例子是5乘5棋盘上的五皇后问题:常规程序一次试一个棋盘,改写成 interaction net 后拆成3183个小操作,最长必须串行的一串只有262步,平均每步约有12个操作可并行。
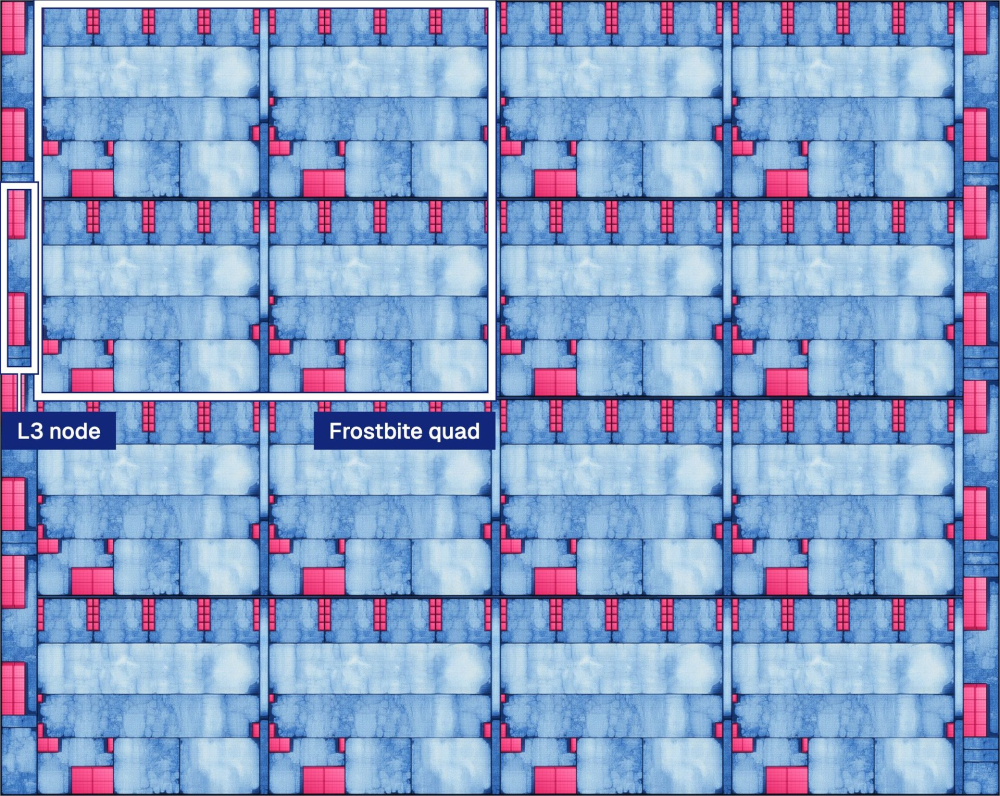
每个瓦片带自己的小容量本地内存,瓦片之间由片上网络连接,4个瓦片加4个 L3 节点构成对外公布的测试集群,完整布局则是16个瓦片。设计在早期综合阶段跑到800兆赫,最终布局定在500兆赫。
更值得看的是流程。智能体先读论文和基准、搭 Python 行为模型,选定架构后就不再写英文说明——按团队的说法,自然语言覆盖不了每个细节、也抓不住错误——而是改用公司自研的 ASL 语言写规格,ASL 可翻译成 Lean 证明器做机器校验。仿真模型比跑 RTL 快约200倍,早期功耗估算偏差接近2.5倍,靠自动回路校准到与电路设计相差5个百分点以内。随后成群的智能体并行提改动,每个想法都要过规格检查、快速模型、电路实现和功耗测量,58个想法里留下37个;期间还冒出人类从未指定过的行为——空闲瓦片会主动去「偷」邻居的活干。
这不是这家公司的第一款设计。8月它公布过面向机器人与无人机的推理加速器 Redwood,称 AI 在两周内从两位人类架构师写的规格里生成了 RTL、验证、固件、驱动与内核,目前同样只在 FPGA 上跑。Frostbite 之后,公司计划开放可在 FPGA 上运行的公开试验平台和一套初步操作系统,最终公开 RTL 与指令集,并把对比对象扩展到更大规模的多核与乱序处理器。
编译自 Tom's Hardware,原标题:"AI agents design an entirely new CPU architecture from scratch, startup claims — Frostbite posts 4.59x the performance per watt of an in-order core in pre-silicon tests"