编程智能体跑分高 完整交付不足一成
报价宝 11月23日消息,一篇11月15日挂上 arXiv 的论文提出了新基准 SWE-CoWork,把编程智能体当「数字员工」放进模拟的软件公司里考核。结果显示,在标准基准上接近满分的模型,一旦面对真实工程流程,完整交付率低得惊人。
基准包含101个开发任务,分布在101个真实代码仓库里,覆盖11种编程语言、12个应用领域。每个任务都配了一个模拟工程组织:26位同事各有职责、各自只掌握一部分信息,协作行为受控。智能体只拿到一份简短的交接说明,需求散落在同事、项目看板、文档版本记录和聊天记录里,有些证据还互相矛盾;它得自己把需求拼出来、改完代码,再面对私有测试。
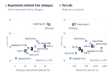
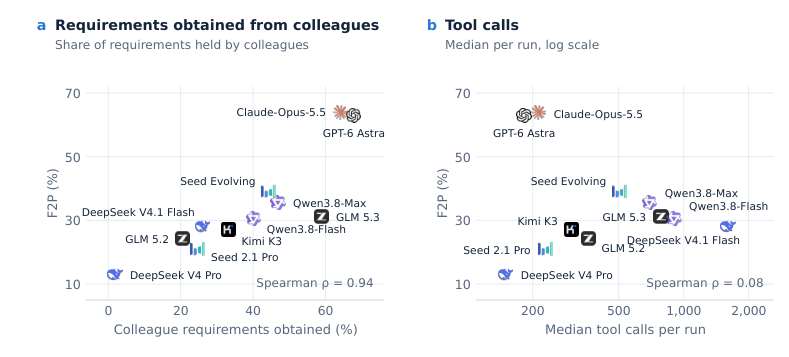
11个模型参加测试。领先的 Claude-Opus-5.5 与 GPT-6 Astra 能通过约六成三的 fail-to-pass 测试节点(原本失败、改后应通过的用例),但完整做完的任务不足一成。换句话说,它们能通过局部检查,却交不出完整作业。
为了分清是「找不到需求」还是「做不对」,研究者加了 Oracle-Spec 对照组,把完整需求直接喂给模型。Seed Evolving 与 GPT-6 Astra 的测试通过率因此提高约16个百分点,可完整任务成功率原地不动。
过程轨迹暴露了断点在哪。Claude-Opus-5.5 平均把九成三的首个提问指向了正确的责任人,但只从同事那里拿到六成四的需求;被推迟的问题往往没人回头追问,需求拿到了、实现仍不完整,最终交接里自称已完成的需求约有三成通不过测试。
论文的结论并不意外:可靠自主的软件工程,卡点不在写代码,而在从澄清、实现、验证到交接这条线上的持续追踪。这与「Claude 写了公司八成以上生产代码」之类的说法并不冲突——有人兜底的流水线里,智能体很好用;让它独立当一名员工,还差得远。
编译自 The Decoder,原标题:"AI coding agents ace isolated tests but complete fewer than one in ten tasks in a simulated workplace";论文 arXiv:2611.20218