AI首破西洋军棋超人关 成本不到8000美元
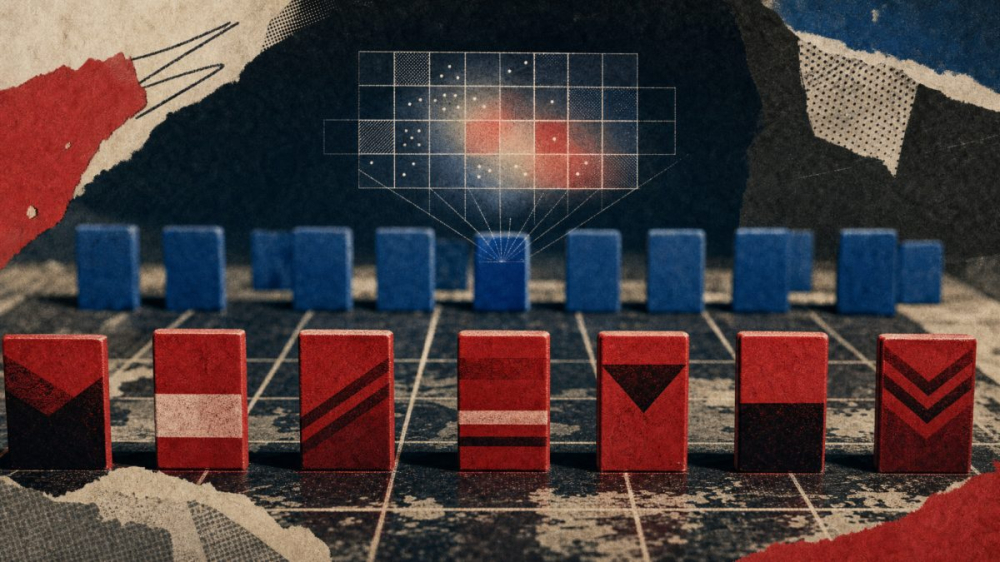
又一个「人类最后堡垒」失守。一个由卡内基梅隆大学、纽约大学、斯坦福大学和麻省理工学院组成的研究团队,训练出Stratego(西洋军棋)AI系统「Ataraxos」,在20局正式对抗中以15胜1负4平的成绩,击败了这项棋类历史上最成功的棋手皮姆·尼梅耶尔(Pim Niemeijer)。
尼梅耶尔拿过4次世界冠军、15次荷兰全国冠军和2次线上世界冠军,累计在世界排名第一的位置上待了600多周。1997年以来参加了每一届世锦赛的棋手乔治·弗兰卡称他是「史上最强的Stratego棋手」。按论文说法,Ataraxos是首个在这款游戏中达到超人水平的AI,有效胜率(平局按半胜计)达85%,这在最高水平对抗中是前所未有的。
Stratego难在哪里?双方各40枚棋子全部背面朝上布阵,可能的初始布局超过10的33次方种;一枚棋子的等级只有在与对方棋子相撞时才会暴露,率先夺旗者获胜。在这种不完全信息博弈中,一步棋的价值不仅取决于后续怎么走,还取决于此前发生了什么——这让从德州扑克AI继承的方法只在隐藏信息很少时才管用(德州扑克开局只有1326种手牌)。
于是,Stratego成了少数人类仍然占优的主流竞技棋类之一。DeepMind曾尝试用DeepNash系统攻下这座山头:据论文转述其作者回忆,DeepNash在1024个TPU节点上训练了两三个月,按2025年价格估算约需300万至450万美元;它在2023年世锦赛上赢下28局中的19局,却输给了包括尼梅耶尔在内的多数顶尖棋手。而Ataraxos只用16张英伟达H100显卡训练一周,再加4张卡训练四天做「信念网络」,总花费不到8000美元——算力成本约为前者的五百分之一,自我对弈局数为三十分之一,训练样本为百分之一。
团队把效率归功于自研的GPU模拟器、更高的样本效率,以及一个关键设计:正则化。训练中额外施加的压力会迫使AI把布阵和着法「摊开」,而不是早早锁死在固定套路里——Stratego的强手需要大量随机性,可预测的棋手会被对手吃透。研究者还会随训练推进逐步放松这种压力、同步调整学习步长:早期大幅变化、大步学习,后期谨慎推进、只做小修正,避免陷入循环或混沌。论文把正则化比作「能量储备」——烧得太快,早期见效快,之后就会丧失继续学习的能力,变得容易被打穿。
Ataraxos还配有一个「信念网络」,用于推断对手那些背面朝上的棋子到底是什么。每一步之前,它会先生成若干可能的局面、推演候选着法,再针对这一次决策做一轮额外的学习。作者称,此前的研究因为隐藏信息太多而跳过了这类搜索。
赛程安排也尽量做到了公平:系列赛分三周进行以避免疲劳,尼梅耶尔从一开始就知道AI不会针对他调整策略,还拿到了1000美元出场费,以及每胜100美元、每平50美元的奖金。但Ataraxos仍处结构性劣势——尼梅耶尔可以在多局中适应它,它却无法适应他,三次世界冠军文森特·德波尔认为这是「重大让子」。即便如此,对手仍描述它棋风「难以读懂」:敢做人类认为太冒险的诈招,落后时死缠烂打,而且「运气好得诡异」。
同一套方法还被复用到其他游戏:在Barrage Stratego变体中,它赢下四个50局系列赛;在合作卡牌游戏《花火》(Hanabi)里刷新了所有变体的纪录,双人版本所需算力比此前领先方案低两个数量级;在中国牌类游戏斗地主中,它战胜了此前的基准系统PerfectDou与DouZero。作者由此给出一个更大胆的结论:大量隐藏信息已不再是强化学习与搜索的障碍——只要能为问题造出快速而准确的模拟器,金融市场、军事冲突和谈判等不完全信息场景中的实用AI都将变得触手可及。
编译自 The Decoder,原标题:"AI beats Stratego's greatest player, ending one of the last human strongholds in board games"