AI智能体能把照片变3D场景 却不知画得对不对
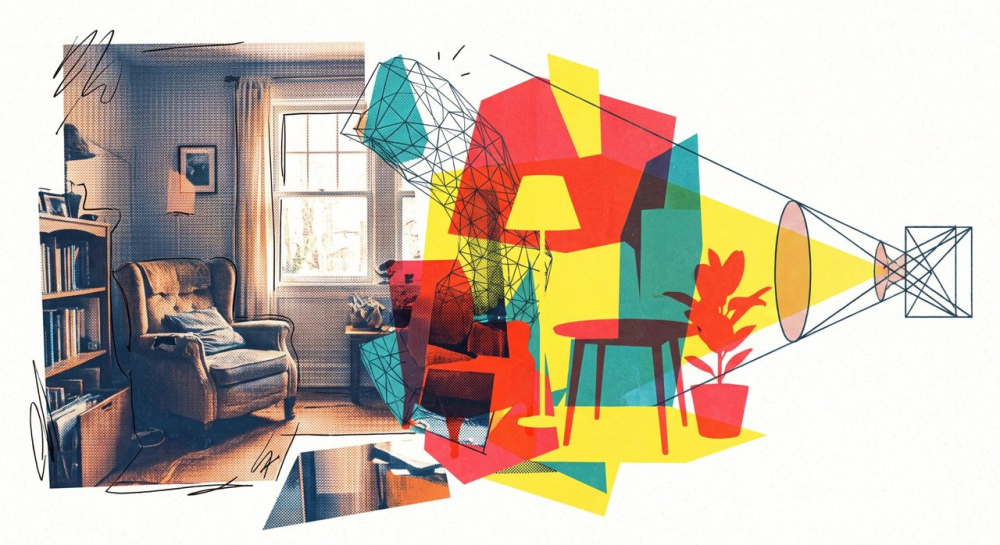
从一张照片重建3D场景,最有用的形态不是一堆网格,而是一段可以查看、修改和查询的程序。这是马里兰大学与AWS研究人员LEGO-Anything项目的出发点:让编程智能体接收单张图像,为Blender编写场景代码,然后反复运行、比对渲染结果、修改代码,逐步逼近原图。
团队同时推出LEGO-Bench基准:208张图片来自104个室内外场景,使用443个注册资产。由于真实照片缺少精确的3D真值,简单合成图又不够真实,基准选择用专业搭建的模拟器场景渲染输入图,兼顾真实感与可评估性。评分分三个维度:有效性(能否交付可用场景)、重建(可见几何的准确度)和外观(重新渲染与原图的相似度)。
六种GPT配置几乎每次都能交出可运行的场景,但准确率差距悬殊:最强的GPT-6 Astra在室内场景达到53.4%,室外只有39.6%,较弱的配置只有15%左右。场景越复杂得分越低,室外又比室内更难。加大推理预算能明显提升成绩,Astra在办公场景子集上从32.3%跃升至61.8%。
研究人员分析智能体的工作步骤后发现了三类典型问题:起步尝试质量差、修订反而破坏已有进展,以及最致命的一点——自我评估不可靠。当模型需要在两个版本中挑出更接近原图的那个时,几何判断的正确率接近甚至低于随机水平。换句话说,智能体基本无法判断自己的场景有没有变好。
这一发现催生了LEGO-Plugin插件:无需任何额外训练,它把起始场景锚定在参考图上,用具体测量替代不可靠的自我判断,并保护已经正确的进展不被后续修改破坏。团队还测试了重建场景能否直接支撑目标检测、分割和深度估计等视觉任务——得益于「场景即程序」的设计,无需训练即可直接提取,但效果平平,目标检测约为专用模型DINO的一半。
GPT-6 Astra在LEGO-Bench上的领先与其他观察相互印证。AI研究者Yoav Artzi认为该模型在空间理解上是重大跃升,并猜测其训练数据包含大量Blender场景之类的3D资产。对于3D软件厂商而言,这或许是一个需要认真对待的信号。
编译自 The Decoder,原标题:"AI agents build 3D scenes from photos but have no idea if they got it right"