开源引擎Strata 12GB显卡跑125B大模型
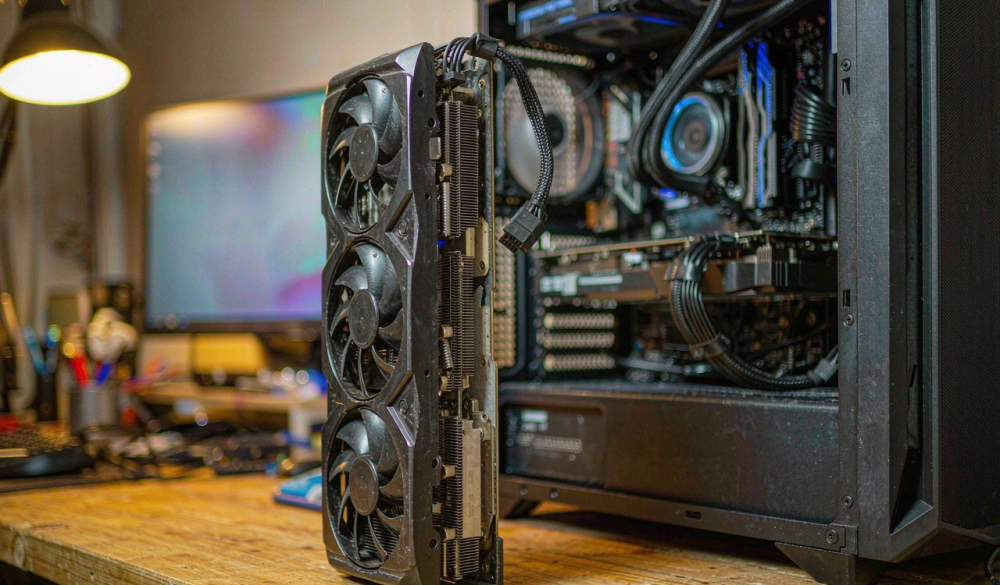
本地大模型又向前迈了一步。开发者Niko1221在GitHub上开源的推理引擎Strata,可以让一块只有12GB显存的消费级显卡,跑起参数量高达1250亿的阿里Qwen3.8-Flash-Next模型——项目文档中的实测数据显示,单张RTX 5070就能以每秒94个词元的速度生成回答,仓库星标已突破1.4万。
这看似矛盾的数字背后是混合专家(MoE)架构的特性。Qwen3.8-Flash-Next共有24576个专家子网络,但每个词元只会激活其中约10个,实际参与运算的参数仅约60亿。Strata据此设计了三层内存调度:高频使用的专家常驻显存,全量专家放进系统内存由CPU并行处理,n-gram嵌入表则留在SSD按需读取。
在此之上,Strata还叠加了投机解码——由一个小模型先猜出后续若干词元,大模型一次性并行验证,可将出字速度提升1.6至1.8倍。运行门槛并不高:一张12GB以上显存的NVIDIA RTX 20系或更新的显卡(AMD RX 7900/9000系亦可)、32GB内存加约80GB硬盘空间,Windows或Linux一键安装。
实测数据颇具说服力:RTX 5070(12GB显存)加Ryzen 5 7600、64GB内存的配置下,Q2_0量化版本每秒生成94个词元、处理3.2万词元提示的速度达每秒2650个词元;AMD RX 9070 XT(16GB)为每秒60个词元。长上下文同样可用,12.8万词元提示下仍能保持每秒约74个词元的输出。社区用户报告,RTX 4090加128GB内存可达每秒约124个词元。
对开发者更实用的一个细节是,Strata在本机开放了兼容OpenAI、Anthropic与Responses协议的API接口,Claude Code、Codex CLI等编程智能体可以直接把本地模型当作后端,数据完全不离开电脑。该项目以MIT协议开源,自9月27日以来已发布30个版本,并于10月5日登上Hacker News首页。
当然,代价同样真实。Q2_0是约2比特的激进量化,远低于业界公认的4比特可靠门槛,社区测试显示视觉任务精度明显下降,所有速度数据也均由作者自行测量;Qwen3.8-Flash-Next本身也是阿里定位社区测试的预览版模型。但正如社区评论所总结的:跑起前沿级大模型的瓶颈,已经不再是显存容量,而是工程。
编译自 GitHub,原标题:"Qwen3.8-Flash-Next on any consumer hardware: one-click install for Windows / Linux"