微软自研芯片Maia 300 内存带宽翻2.5倍
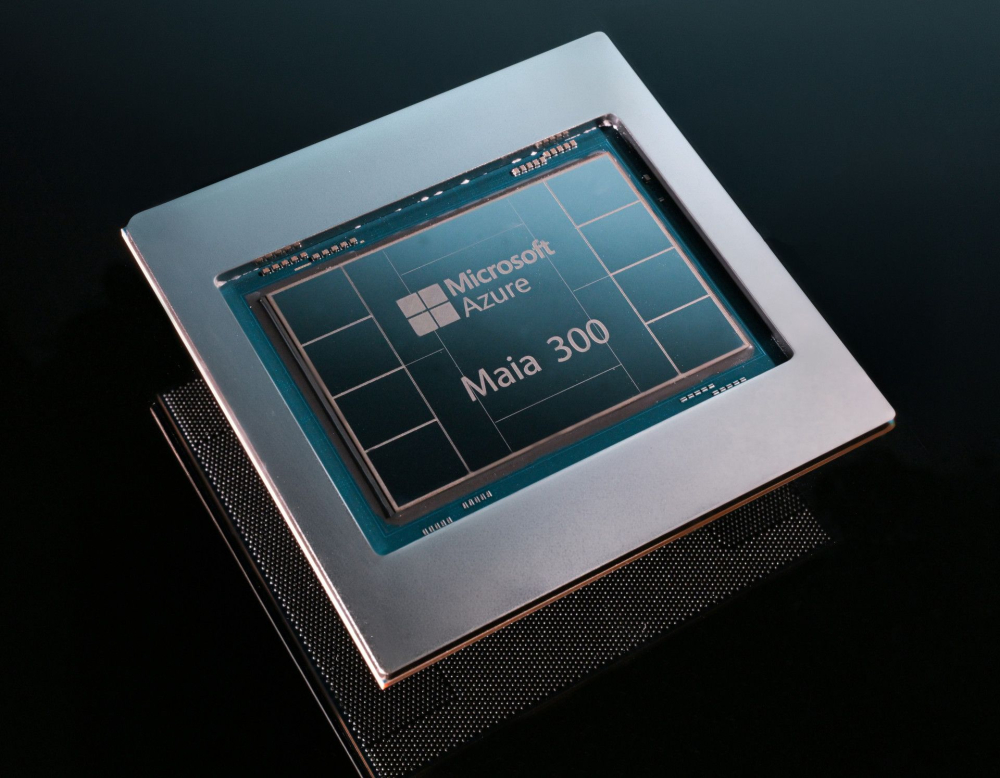
微软把自研芯片从配角提到了主力位置。云与AI执行副总裁Scott Guthrie在官方博客宣布,从2027年起,Azure Maia加速器将扩展到多吉瓦级部署规模,Maia将成为微软自家产品与服务的主要推理系统;承担这一角色的新一代芯片Maia 300的架构细节也随之公布。
与上代Maia 200相比,Maia 300从单芯片转向多芯粒封装:计算芯粒采用台积电N2P工艺,内存控制器与输入输出功能则拆分到独立芯粒。每颗加速器配备8个HBM4内存堆栈,提供288GB容量和18TB每秒的峰值带宽,而上代只有216GB和7.1TB每秒——内存带宽提升2.5倍,算力则只增加约36%。
这是有意为之的取舍。在推理的逐token解码阶段——恰恰是长推理链和智能体任务最吃时间的地方——加速器大部分时间在等数据到位而不是做运算。Maia 300为此把数据尽量挪到计算单元旁边:跨芯粒的非均匀内存布局、软件管理的片上SRAM,以及更窄的数值格式,包括增强版MXFP4和低于3位的存储格式,并支持硬件格式转换。微软称该芯片每兆瓦电力可多产出40%的token,一个机架的token吞吐量最高可达Maia 200机架的7倍。
机架层面的数字同样可观:一个Maia 300机架容纳96颗加速器,功耗167千瓦,合计27.6TB高带宽内存、1.7PB每秒总带宽。据媒体报道,微软还在与台积电洽谈产能,计划2027年生产超过30万颗Maia 300,这些订单要与英伟达、谷歌、亚马逊争夺同样的先进制程产线。
时机耐人寻味。Gartner本周预测,2026年AI基础设施支出将接近1万亿美元,而AI收入至少要到2032年才能覆盖建设成本、实现盈利;与此同时,英伟达数据中心业务单季收入达890亿美元、毛利率高达75%,其中约一半来自超大规模云厂商。如果最大的买家不再为这些利润率买单,AI产业链中估值最高的环节将首当其冲。
走上自研硅路线的也不止微软一家:谷歌的TPU系统已开始对外确认收入,并称外部需求强劲;Anthropic通过博通锁定了2027年3.5GW的TPU算力;亚马逊称其芯片业务年化收入已突破200亿美元;OpenAI也亮出了自研的Jalapeno加速器。两年前,微软还向欧盟委员会强调谷歌是唯一实现AI全栈垂直整合的公司,如今它自己也走上了同一条路。
编译自 TechRadar Pro,原标题:“Microsoft’s Maia 300 swaps raw compute for a 2.5x memory bandwidth gain as it moves to make in-house silicon its main AI engine while claiming a 40 Percent efficiency bump”