Cerebras用59片晶圆跑3万亿参数模型
一块晶圆级芯片装不下一个前沿大模型——这是 Cerebras 最常被问到的问题。公司最新博客拆解了自家方案:单片 WSE-3T 晶圆只有 44GB 片上内存,而万亿参数级模型的权重要按 TB 算。办法是把模型按层切开,摊到多片晶圆上组成流水线,多万亿参数模型可以跑到每秒一千到两千个以上的 token。
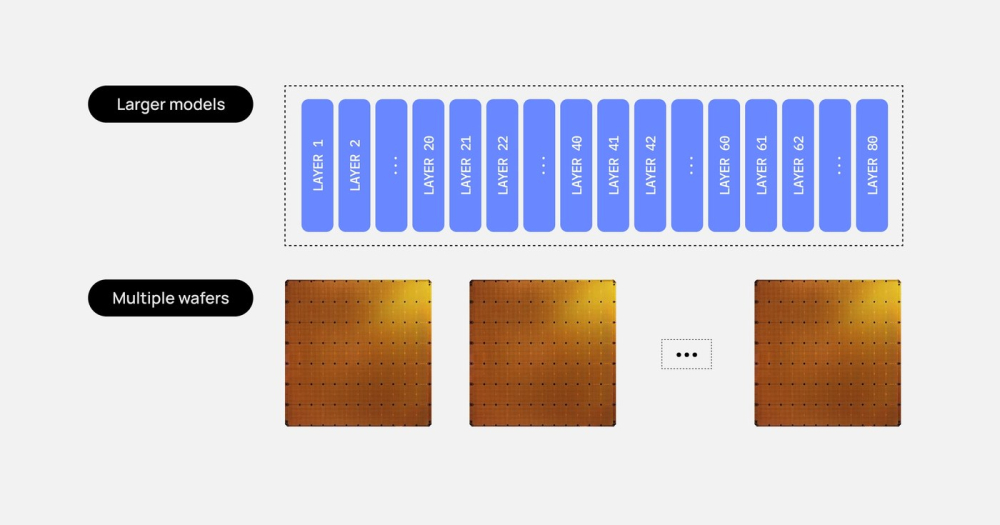
博客以开源模型 Kimi K3 为例:约3万亿参数,共93层,其中69层是线性注意力层、24层是稠密的全注意力层。按4比特量化存放,全部权重约1.5TB,摊到每层约16GB。
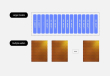
怎么分取决于层类型。稠密层要为每个在途请求保存键值缓存(KV cache),所以每片晶圆只放一层,剩下的内存全留给缓存;线性注意力层只为每个请求保留一个固定大小的小状态,不必逐词存键值,一层16GB,44GB 的晶圆正好塞两层。69个线性层需要35片,24个稠密层用24片,合计59片晶圆。
接法像流水线:编译器把各层映射到晶圆上,运行时规划 token 的路径,晶圆之间只传激活值,走以太网 RDMA,单跳约2微秒。权重从此不动,也不必把一层拆到多片晶圆上。第1片跑完前两层把结果交给第2片,依次往后,最后一片吐出下一个 token。
流水线最怕空转,但并发请求会把整条线填满:同一时刻,第3级在处理请求A的 token,第2级在处理请求B,第1级在处理请求C。能同时服务多少请求,由稠密层晶圆的缓存空间封顶——44GB 减去一层16GB,剩下的28GB 用来存 KV cache。
Cerebras 提醒,单看并发数或批大小都说明不了推理系统的效率,更有意义的指标是在相同输出速度下比较每兆瓦功率每秒产出的 token 数。博客顺带列了 Kimi K3 的成绩:终端基准 Terminal-Bench 2.1 拿到百分之八十八点三,略低于 GPT-5.6 Sol 的百分之八十八点八;网页智能体基准 BrowseComp 百分之九十一点二,反超对手的百分之九十点四。
编译自 Cerebras 官方博客,原标题:"How we deploy Trillion-parameter frontier models on Cerebras"