鲲鹏920跑赢主流x86 北大深度优化ABACUS
密度泛函理论(DFT)是研究半导体、金属等关键材料性质的主流第一性原理方法,庞大的计算量一直是它的短板。在北京大学鲲鹏昇腾科教创新卓越中心支持下,北京大学力学与工程科学学院陈默涵研究员团队完成了国产开源密度泛函软件ABACUS(原子算筹)在华为鲲鹏920全系列平台上的适配,并把19类材料领域核心算子逐项优化,性能反超同代主流x86平台。
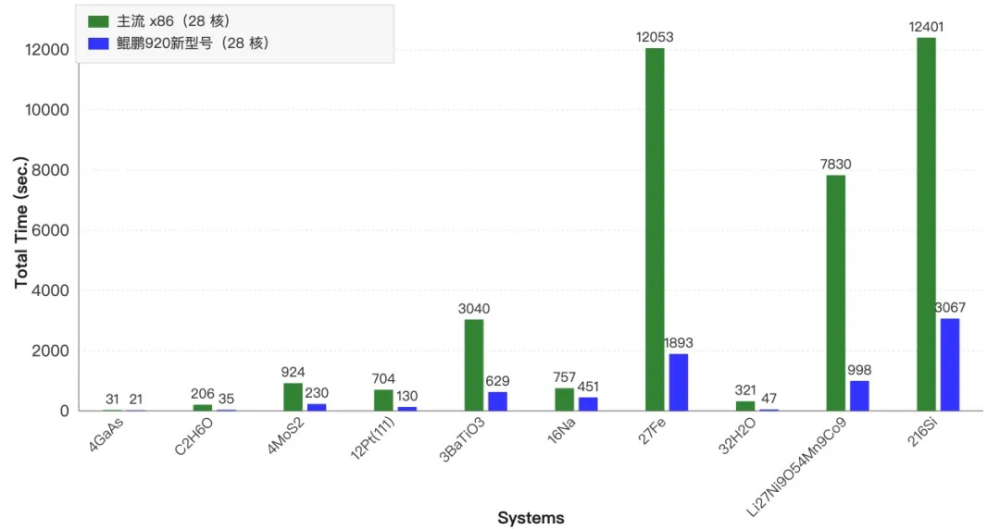
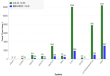
成绩单相当亮眼:在与业界主流CPU相同的28核、28进程×1线程配置下,采用SVE指令集的版本在标准测试集上快1.3至3.9倍;单节点满核并启用矩阵运算单元后,最高快10.7倍。随机波函数DFT算例的差距更明显,矩阵运算指令集版本快6.1至20.1倍。相关代码已经推送到GitHub开源社区。
团队先解决「跑得起来」的问题:鲲鹏920各型号支持的向量指令集并不相同,分别是NEON、SVE和SVE512,还内置专门的矩阵运算单元,沿用通用编译选项会让这些硬件能力一直闲置。团队为三款芯片各自适配了一条编译路径,并新增USE_KML编译选项接入鲲鹏数学库,调整KFFT、KScaLAPACK等接口差异后完成整体适配,四类集成测试的数值结果与业界主流实现一致。
接下来是「跑得更快」:DFT的算力主要耗在一批被反复调用的小算子上,而这正是通用编译器和数学库的盲区。团队把广义拉盖尔多项式从递归改成迭代递推,复杂度从平方级降到线性,同一算子百万次调用测试快约8倍;多项式插值的区间查找换成二分查找后,400项的表平均比较次数从约200次降到9次。所有算子的数值结果均复核无误。
这套经验不止留在ABACUS里。团队借助华为一站式开发套件DevKit的源码自动优化能力沉淀调优方法,在920新型号上实测,8原子温稠密碳算例提速2.28倍,512个硅原子体系算例提速2.66倍。对鲲鹏生态而言,这次适配支撑起几十万行代码的大型科学计算软件,调优经验还能沉淀为其他科学软件可复用的基础工具。
编译自 华为计算,原标题:「鲲鹏920上跑出超越同代主流硬件的性能:北大陈默涵团队完成ABACUS(原子算筹)软件的深度优化,优化19类材料核心算子」