腾讯混元发布Hyra 2.0 让AI自己造工具
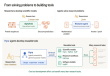
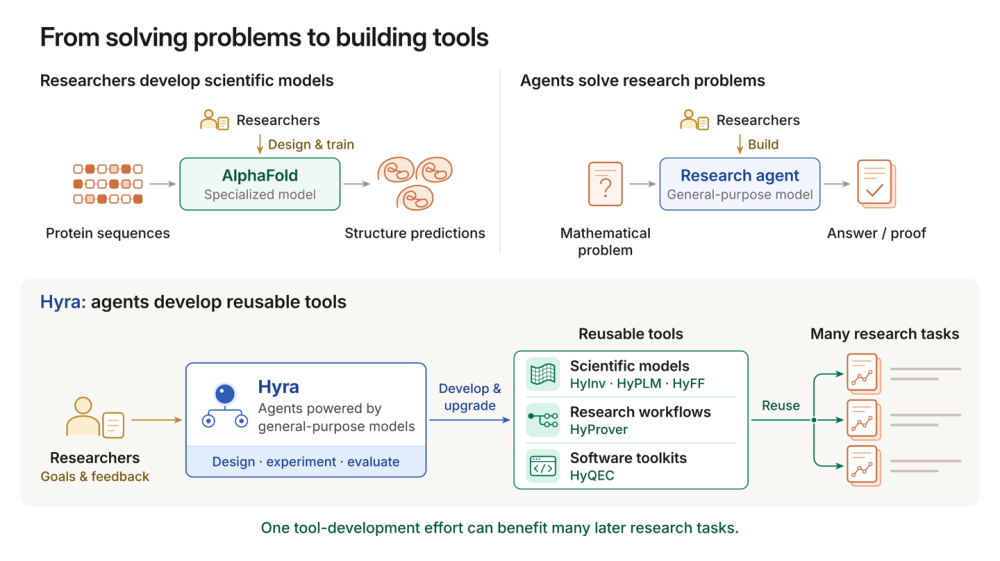
腾讯混元今日发布新一代 AI 科研系统 Hyra 2.0。与三个月前专注「刷题解题」的 1.0 版不同,这一版把研发重点转向「造工具」:让通用智能体参与科学模型、研究工作流和软件工具的研发与升级,让一次研发的成果在后续研究中被反复使用,形成所谓的「智能复利」。
Hyra 1.0 曾在发布一周后驱动开源模型 Hy3,全自动解决了加法组合学中悬置五十余年的「和集与差集最优指数」问题,是国产开源模型首次全自动解决数学开放问题。混元团队认为,刷题式突破的成果无法自动提升下一次研究的能力,而工具升级的收益却能惠及所有下游任务——这正是 2.0 的出发点。
架构上,Hyra 2.0 把研究工作拆分为 Overall、Mission 和 Worker 三层:Overall 负责与人类研究者沟通、对齐目标并协调资源;Mission 长期负责单一研究问题,判断路线取舍;Worker 则独立读代码、做实验、分析失败原因,甚至可以质疑 Mission 的判断。系统接入团队真实研发环境,在企业微信对齐需求、在计算平台提交实验,大算力操作需人工审批,项目状态、分层记忆与共享知识库 Books 三套存储分离,复盘时可复用方法沉淀为 skill 供后续任务调用。
官方展示了多项已落地的成果。蛋白质设计模型 HyInv 仅有 196 万参数,由 Hyra 2.0 完成从预训练到推理优化的全流程,生成速度比业内常用的 ProteinMPNN 快 57 倍,在单张 H20 上约 50 毫秒即可设计 128 条约 400 残基的序列;6.5 亿参数的蛋白质语言模型 HyPLM-Flash 训练用量仅为同类模型的几分之一,推理速度在 12 个对比模型中最快。
面向分子模拟的原子级基础模型 HyFF 提供五档规模,全部位于精度与速度的帕累托前沿,已支撑近 6 万原子体系的 100 纳秒模拟;数学工作流 HyProver 协同数学家完成并核验了丘成桐圆周作用猜想等猜想的证明;量子纠错系统 HyQEC 构造出编码效率较原榜首提升约 48% 的新码,并为排行榜 187 个条目中的 178 个完成精确码距认证。
系统还优化了开源 RISC-V 处理器「香山」,使 SPEC CPU2006 每 GHz 性能提升 5.79% 而芯片面积仅增加 0.3%;在机器人本体设计上,它自主提出五指长度递增的「旋梯手」结构,同等训练预算下仿真旋转速度反超原方案 28.6%。目前 Hyra 2.0 已参与下一代混元模型的研发,相关成果持续公开在 GitHub 仓库供社区复用。
编译自 腾讯混元官方博客,原标题:“Hyra 2.0 发布:为模型研发打造可复用工具”