云运维基准测试:最强模型仅六成及格
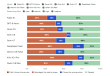
报价宝综合消息云运维基准测试:最强模型仅六成及格让AI智能体接管云端运维靠谱吗?密歇根大学陈昂团队给出的量化答案是:还差得远。该团队发布开源基准CloudOpsBench 1.0,包含45个AWS云上的真实运维任务,从修复故障服务、清理资源、收紧访问权限到发布更新、下线项目,全部由资深DevOps工程师设计,任务在真实云环境和仿真器中各运行一遍,项目以Apache 2.0协议在GitHub开源。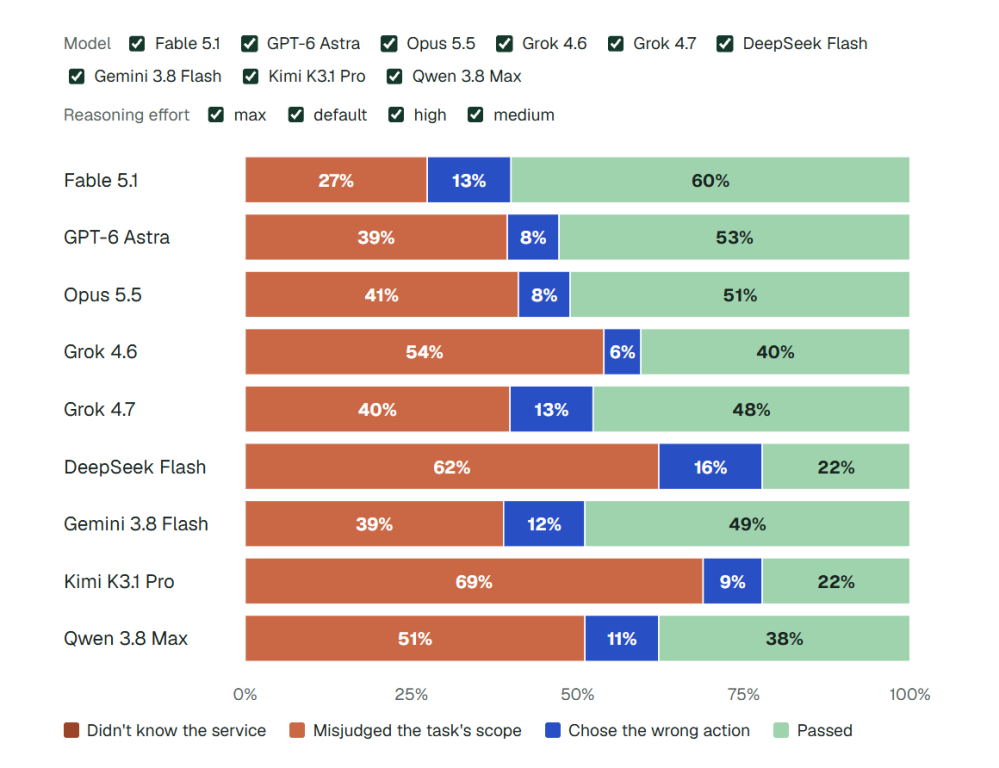 测试结果给最前沿的模型泼了冷水:Claude Fable 5.1通过率60%,GPT-6 Astra为53%,其余主流模型更低,DeepSeek Flash和Kimi K3.1 Pro只有22%。
失败分析比分数更有价值:约80%的失败并非模型缺乏知识,而是推理出了问题——误判任务范围、没有检查所有相关服务、或是提前收工。约20%属于错误操作,其中一些对基础设施造成了不可逆的破坏。
研究团队指出,这类任务的特点是「做错比不做更糟」,与常见的问答或编码基准有本质区别。CloudOpsBench同时提供真实云与仿真两种运行模式,方便研究者低成本复现实验并分析失败模式,团队已公布详细报告。
后续版本计划扩展到谷歌云、Azure和甲骨文云。随着各家争相把智能体塞进生产环境,这个基准提醒业界:让AI安全地操作真实基础设施,推理能力仍是最大瓶颈。
编译自 The Decoder,原标题:"New open-source benchmark reveals reasoning as the biggest bottleneck for AI in cloud operations"
测试结果给最前沿的模型泼了冷水:Claude Fable 5.1通过率60%,GPT-6 Astra为53%,其余主流模型更低,DeepSeek Flash和Kimi K3.1 Pro只有22%。
失败分析比分数更有价值:约80%的失败并非模型缺乏知识,而是推理出了问题——误判任务范围、没有检查所有相关服务、或是提前收工。约20%属于错误操作,其中一些对基础设施造成了不可逆的破坏。
研究团队指出,这类任务的特点是「做错比不做更糟」,与常见的问答或编码基准有本质区别。CloudOpsBench同时提供真实云与仿真两种运行模式,方便研究者低成本复现实验并分析失败模式,团队已公布详细报告。
后续版本计划扩展到谷歌云、Azure和甲骨文云。随着各家争相把智能体塞进生产环境,这个基准提醒业界:让AI安全地操作真实基础设施,推理能力仍是最大瓶颈。
编译自 The Decoder,原标题:"New open-source benchmark reveals reasoning as the biggest bottleneck for AI in cloud operations"