美国创企3200万美元训出编程开源SOTA
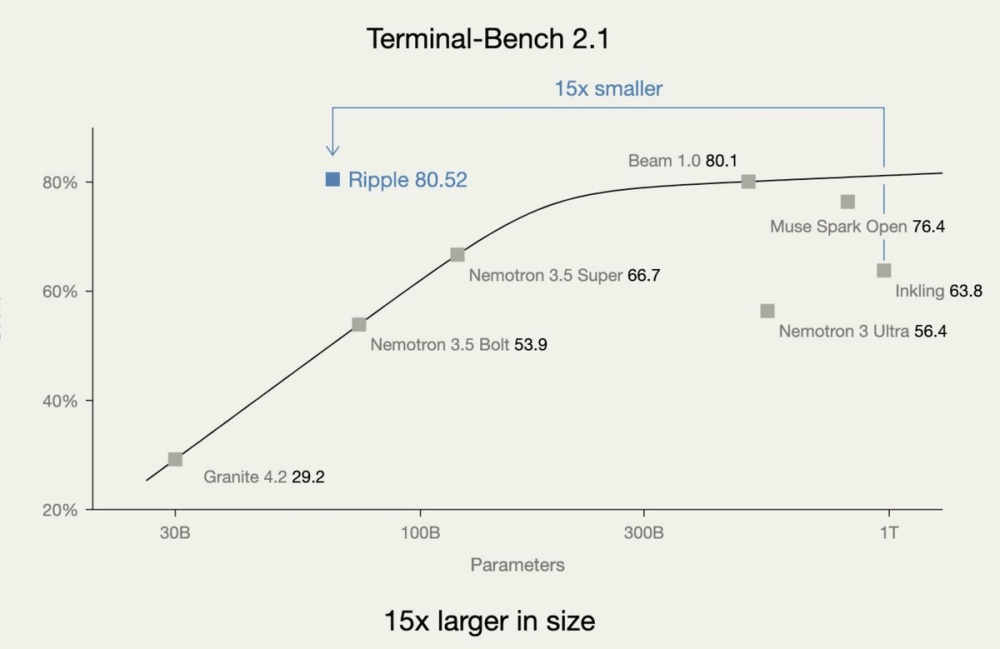
美国 AI 实验室 Ricursive Intelligence 发布 Ripple-65B Preview,一款 65B 稠密(dense)通用模型,主打智能体编程。官方称其在 TerminalBench 2.1 上拿到 80.52 分,是美国开源权重模型中的最好成绩。
这个模型原本是该公司芯片设计平台的内部引擎。Ricursive 定位是全栈实验室,同时优化硬件、软件与模型,目标是让系统具备自我改进能力;Ripple 是先为自家平台从零训练,再拿出通用版本对外开放。
规格上,Ripple 预训练用了 12 万亿 token,支持最长 100 万 token 上下文。架构选择的是「薄而深」的稠密 Transformer(d_model 5120、80 层),而非当下主流的 MoE。官方理由是稠密结构推理延迟更低,参数规模也小,可以跑在 NVIDIA DGX Spark 这类本地设备上。
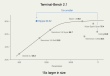
官方对比图显示,Ripple 以 65B 规模取得 80.52 分,与参数大 15 倍的 Beam 1.0(80.1)基本持平,同时高于 Muse Spark Open(76.4)、Nemotron 3.5 Super(66.7)与 Inkling(63.8)。
更受关注的是成本。Ricursive 称 Ripple 从预训练到后训练的全流程研发只花了 3200 万美元,约为上一代智能体编程开源 SOTA 的十分之一。做法上公司没有外购后训练数据,而是自建合成数据管线与质量过滤,用逐步加难的强化学习课程把分数推上去。
模型已在 Hugging Face、Together AI、GMI Cloud、OpenRouter 与 Fireworks 上线。对「美国来源、可私有化部署」有硬性要求的政府、国防与芯片设计客户,是这款模型最现实的目标群体。
不过「美国开源 SOTA」这个限定也意味着,一旦把 Qwen 等中国开源模型纳入比较,80.52 分未必还是第一;对普通本地用户来说,65B 稠密模型依然偏重。这一点开发者社区已有讨论。
编译自 Ricursive Intelligence,原标题:"Ripple-65B Preview"