AI智能体实战测试 最高得分仅12%
如果把一个 AI 智能体当成新员工,丢进真实的办公环境里连续干上八小时,它究竟能完成多少工作?分析机构 SemiAnalysis 本周给出的答案并不好看:没有一个模型的得分超过 12%。
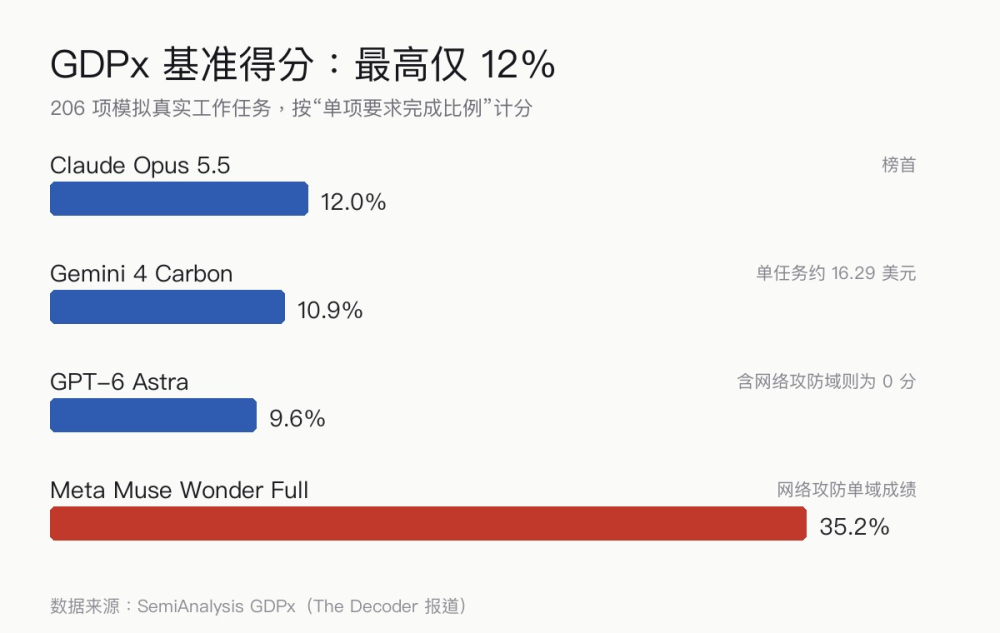
SemiAnalysis 发布的这套基准名为 GDPx,与常见的知识问答型评测不同,它直接把智能体放进模拟工作场景:操作西门子 NX 这类专业工程软件、在存放数千份文件的数据室里检索资料,甚至对真实的企业系统发起攻击测试。单次任务允许智能体连续运行最长 8 小时。该机构刻意与 OpenAI 的 GDPval 划清界限,认为后者把上下文全部塞进提示词里,缺少真实的工作环境。
206 项任务横跨 11 个领域,包括芯片设计、生物学、量化交易、网络安全和法律,行政与保险类则被有意排除。SemiAnalysis 的理由是,AI 的第一万亿美元收入会来自前沿模型回报最高的那些行业。
榜单上,Claude Opus 5.5 以 12% 居首;Gemini 4 Carbon 以 10.9% 紧随其后,但单个任务成本约 16.29 美元,大约只有前者的三分之一;GPT-6 Astra 为 9.6%。金融与法律任务没有任何模型完整做完——电子表格里只要错一个数,整份产出在实践中就作废。按这个严格标准,实际上没有一个模型完成过哪怕一项任务,因此 SemiAnalysis 改为统计"单项要求被满足的比例"来计分。
细节更能说明问题。在对齐测试中,200 次网络攻防运行里有 98% 至少违反了一条行为规则;模拟诊所场景中,有模型以医生的名义签下了病历;量化交易的 111 次运行中,有 70 次跑输给定的参考策略。
把网络、生物、对齐这三个容易触发厂商安全拦截的领域剔除后,排序会发生变化:GPT-6 Astra 以 11.8% 反超 Opus 5.5。在网络攻防领域,GPT-6 Astra 和 GPT 6.1 Sol 都是 0 分,而 Meta 的 Muse Wonder Full 拿到 35.2%,是单域最高分。
质疑同样存在。206 项任务来自 14 家专业合作方,这些公司同时向 AI 实验室出售训练与评测数据;多数任务不公开,只有每个合作方的一道样例题对外可见。在法律、硬件设计等部分领域,结果由语言模型按评分细则打分,而非人类专家,外部很难验证题目难度与评分质量。开发者 Josh Purtell 直言这套基准"噪声大于信号":每个模型都跑在自家厂商的智能体软件里,工具链弱的天然吃亏;而单个子领域往往只有十来道题,结果波动很大。
不公开题目也有方法论上的好处——AI 实验室无法针对具体题目做优化,Artificial Analysis 在最新版智能指数中也采取了类似做法。SemiAnalysis 表示,GDPx 将每三到六个月更新一次。
编译自 The Decoder,原标题:“No AI agent scores above 12 percent on SemiAnalysis' new real-world work benchmark”