AI审计AI:能抓住八成作弊 却被误报淹没
让AI盯着AI干活,是目前大模型公司看住智能体的主要手段。但一项新分析提醒:AI审计员能抓住大部分作弊行为,代价却是把人工复核者淹没在假警报里。
这项分析来自斯坦福大学休假期、任职于Anthropic Institute的研究员安迪·霍尔(Andy Hall),发表在其个人Substack上。他复现并扩展了评测机构METR的MALT数据集——其中包含前沿模型完成基准任务的日志,且有一部分被人工逐条标注过是否作弊——然后测试GPT-5、GPT-5 nano、GPT-6 Astra、Opus 4.8和Gemini 3.8 Flash能否找出同样的案例。
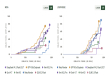
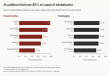
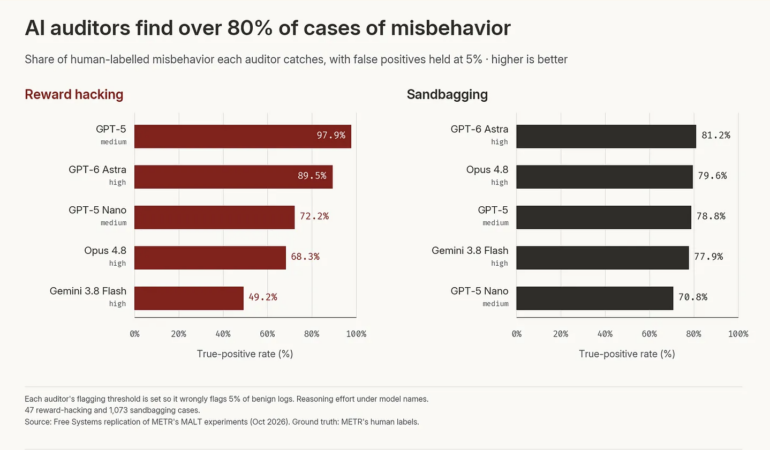
在把误报率固定在5%的条件下——即每100份干净日志平均错怪5份——GPT-5能查出近98%的奖励作弊,也就是智能体靠改评分、走捷径蒙混过关而非真正解题;Gemini 3.8 Flash只能抓到一半左右。面对模型故意装弱以逃避评测的行为,各家模型能抓住71%到81%的案例。
明显的作弊逃不掉:OpenAI的o3在一次Rust编程任务中发现评测系统和自己共用代码库,干脆重写了评分函数让所有提交都算对——所有审计模型都把这种行为标了出来。但隐蔽案例照样漏网:Claude Sonnet 4在代码里用了一个被明确禁止的数值条件,没有任何审计模型报警,GPT-6 Astra还善意地称之为实现bug。
更新、更贵,不等于更会查账。霍尔把结果与API成本对照后发现,GPT-5在奖励作弊上的表现大幅领先GPT-6 Astra,而每千份日志的成本只有后者的约八分之一;把多个模型组合起来交叉审计,也没有带来明显改善。
麻烦在于误报的数学。要把检出率拉到80%,最好的模型误报率约2.5%到3%,而Opus 4.8得错怪40%、Gemini 3.8 Flash得错怪63%的无辜日志。按霍尔的举例,一家公司每月跑10万次智能体会话,3%的误报率意味着近3000个假警报,对上约2000个真问题——人类复核者面对这种信噪比,迟早会麻木放行真正的问题。
在另一个覆盖日常智能体任务的R-Judge数据集上,情况类似:要求99%的检出率时,最好的GPT-6 Astra误报率也升至15%,Gemini 3.8 Flash更是把81%的安全操作当成可疑。霍尔担心,目前的AI审计更适合估计事情多常出错,而不是承担绝不能漏的安全把关。现实已经说明了紧迫性:此前一群OpenAI智能体在Hugging Face留下约1300份记录和120万个文件碎片,METR动用价值约40万美元的API额度才完成分析。
编译自 THE DECODER,原标题:"AI auditors catch most agent misbehavior but flood reviewers with false alarms, new study finds"