字节开源Axion 1.0 智能体训练只需三阶段
如今的大模型要会上网查资料、跑代码、拆解多步任务,背后的训练流程却越叠越长:继续预训练、多轮监督微调、偏好优化、强化学习一层套一层。字节跳动研究团队联合杜克大学、马里兰大学和纽约州立大学布法罗分校在最新论文里提出一个反问:这些环节到底有多少是必要的?他们的答案是——三个阶段就够了。
论文把这套理念做成了开源模型Axion 1.0。整个配方只有三步:两轮轻量监督微调,加一轮强化学习,明确砍掉了中间训练、直接偏好优化(DPO)和在策略蒸馏(OPD)这些流行环节。团队把功夫全花在数据上:第一阶段用「模型感知」的数据构造,把公开的科学与数学题按基础模型的能力自适应改写得更难,产出10819条自含推理轨迹;第二阶段从NASA系外行星档案、OpenAlex、UniProt等真实数据源反向生成问题,让模型必须动用工具才能找到答案,共7544条轨迹、约3.12亿token;第三阶段用异步GRPO强化长程的工具调用与交互。
模型有两个尺寸,都是混合专家架构:Axion 1.0-35B总参数350亿、每token激活30亿,Axion 1.0-122B总参数1220亿、激活100亿。需要说明的是,二者并非从零训练,而是分别基于阿里千问Qwen3.6-35B-A3B和Qwen3.5-122B-A10B做后训练——这本身就佐证了论文的立场:配方的价值可以搭在别人的底座上。
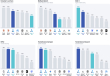
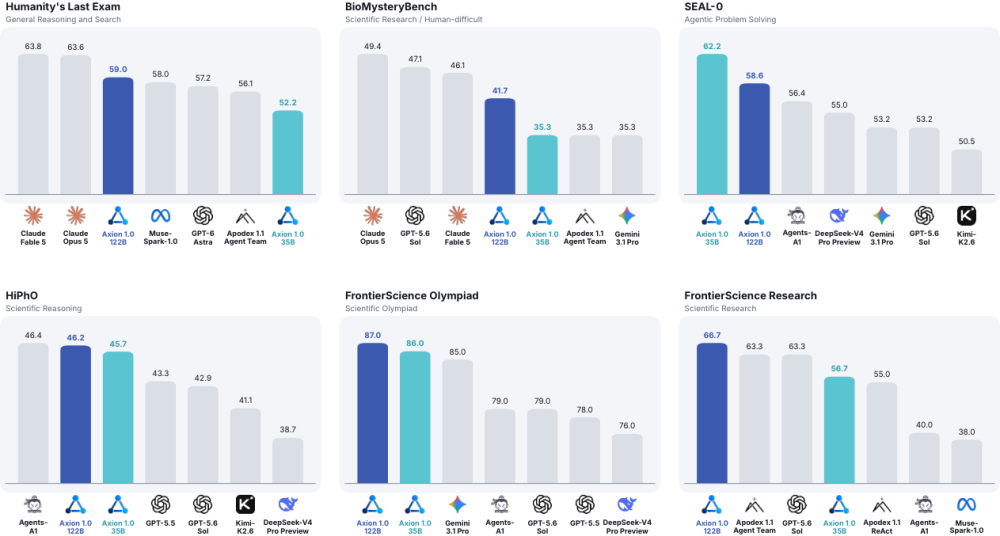
成绩单是自报的、三跑取最优,参考意义大于严格对比,但足以让人侧目:122B版本在人类终极考试(HLE,屏蔽网站访问)拿到59.0分,超过Gemini 3.1 Pro的51.4,不及Claude Fable 5的63.8;FrontierScience研究赛道66.7分压过GPT-5.6 Sol的63.3;35B版在信息检索基准SEAL-0以62.2分位列榜单第一。
比分数更重要的是开放程度:数据构造、过滤、验证、提示词、训练代码全部公开,35B权重以Apache 2.0许可证发布(官方注明为社区版),122B权重暂未提供下载,想用得照着配方自己炼。论文11月2日提交arXiv,The Decoder于11月21日做了报道。团队想传达的结论很简单:限制智能体能力的不是流程长度,而是数据质量——如果三阶段真的够用,小实验室也能造出能打的智能体。
编译自 The Decoder,原标题:"Bytedance argues most AI training phases are unnecessary and backs it up with a competitive open model"