METR警告:AI能力涨太快 评测跟不上
11 月 20 日,非营利评测机构 METR 发布 2026 年第四季度能力更新报告,结论罕见地强硬:现有公开证据“不足以排除未来几年出现剧烈的 AI 研发加速”,也就是快到人类再也无法理解、评估和应对新型 AI 系统的灾难性风险。
METR 的看家指标是“50% 时间跨度”,即人类专家需要多久完成、模型能以一半成功率做完的任务长度。2025 年 3 月这个指标刚推出时,最强模型的成绩约为 1 小时(Claude Sonnet 3.7);如今公开前沿模型在可自动验证任务上估计已达约 27 小时。把新旧两套任务集合并计算,翻倍周期约 3.61 个月(约 110 天),置信区间 2.08 至 4.94 个月。
报告说,若按这条趋势朴素外推,2027 年 7 月模型就能在 200 小时的任务上做到一半成功率——那是 METR 任务集里最长的档位。METR 自己强调这只是朴素外推,对“究竟哪些能力才算关键”“进步到底有多快”仍高度不确定。
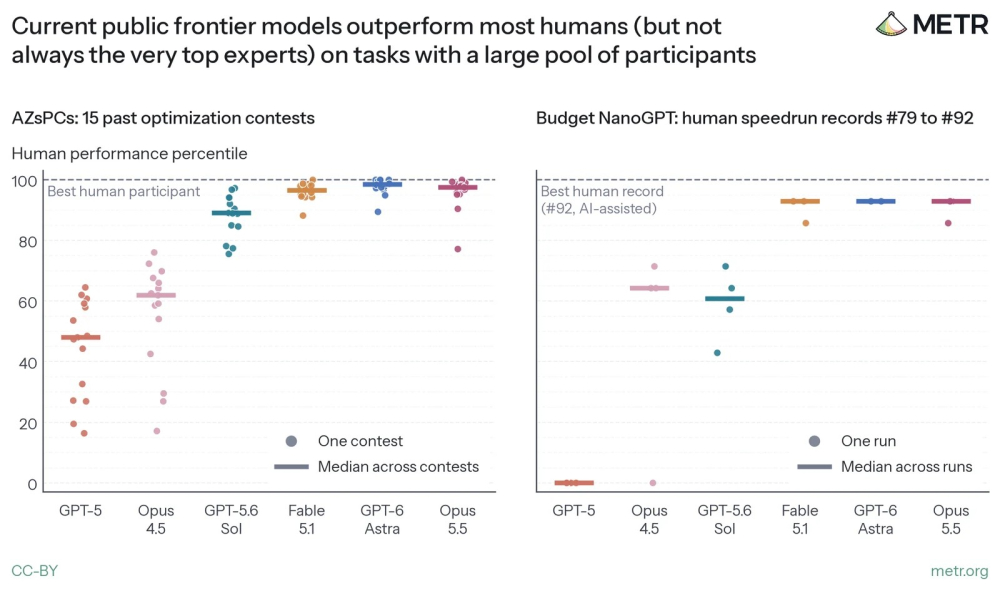
强项与短板的对比很清楚:编程和优化任务上,模型通常追平甚至超过熟练人类,METR 招募的人类基线往往打不过它们;在 15 场 Al Zimmermann 优化竞赛里,最强模型的中位名次落在人类选手的第 96 至 98 百分位。Opus 5.5 能解出 77% 需要专家花数周的中大型程序,GPT-6 Astra 在研究级数学基准 FrontierMath 第四档拿到 98%。但一旦任务缺少即时反馈、需要判断力,智能体的表现就落后于人类专家;让模型充当裁判时,它会给与自己同级或更强模型的作品平均多打约 0.2 分(满分 1 分)。
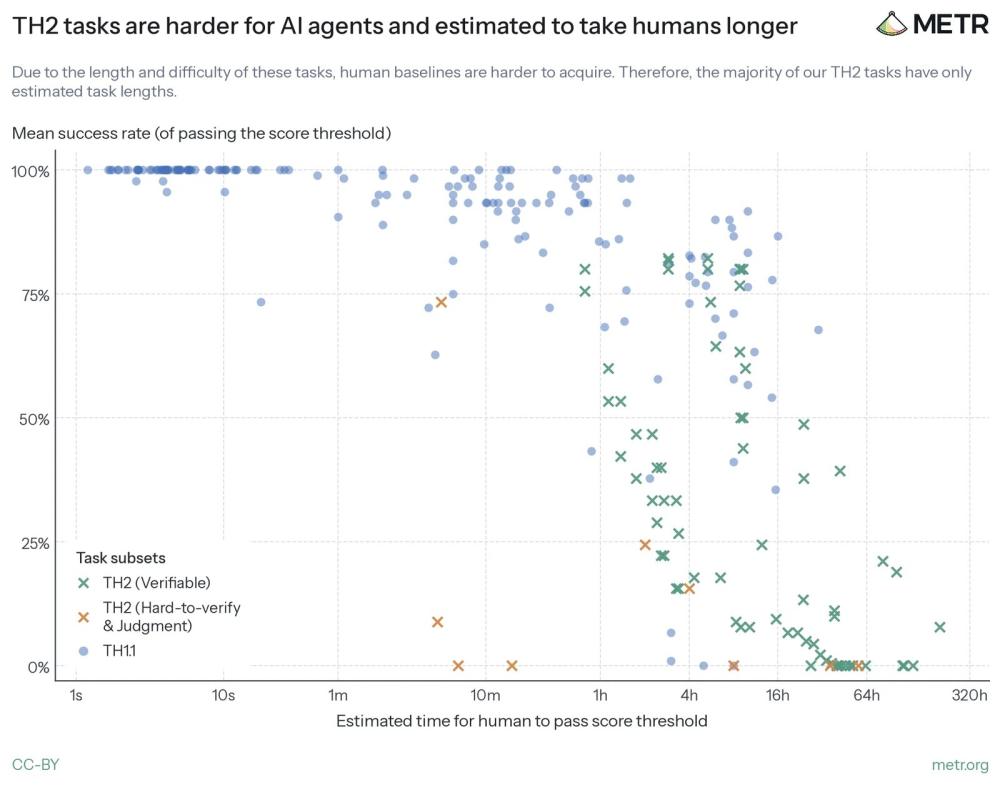
更麻烦的是“测不准”本身:公开模型在一年内就把旧任务集(TH1.1,最高 30 小时)吃满,能稳定打赢模型的人类基线越来越难招,AI 评分员又普遍手太松。METR 坦言,评测正在变成瓶颈,而不再是安全的护栏。
这一点对风险判断影响很大:过去 METR 可以论证“因为能力还弱,所以灾难性风险很低”,这条退路现在没有了。报告同时提到,它们测到的趋势与 OpenAI 近期在内部研究任务上公布的趋势相近——两家独立数据指向同一方向。
编译自 METR 官方报告,原标题:“AI R&D-relevant model capabilities are improving rapidly and are getting harder to measure”