更轻,但更好!科大讯飞首发工业级中文预训练模型
近年来,以超大规模模型、海量训练数据、自监督学习准则为特点的无监督预训练模型备受关注。具有高通用性的无监督预训练大模型,结合知识和海量数据进行融合学习,通过提取原始数据的深层表征,实现对于下游任务的通
2023-01-06 资讯 我要分享图像分类任务不用冷启动,PaddlePaddle一口气…
PaddlePaddle在不断增加官方支持的模型的同时,也在关注预训练模型的丰富度。在过去的版本中,已发...
华为云ModelArts刷新深度学习模型训练世界纪录
近日,斯坦福大学发布了DAWNBenchmark最新成绩,在图像识别(ResNet50-on-ImageNet,93%以上精度)的...
【绕过个资共享障碍找到AI新出路】联合学习颠覆集中式ML训练
自AI浪潮掀起以来,要打造表现好的模型,就需要越多的训练资料。然而,越来越严格的个资保护规范,限制了企业取得资料的行为,成为AI大数据的冲突。但联合学习,可望打破这个限制
微软更新ML.NET模型建置器现可利用Azure训练图片分类器
由于受限于本机运算资源,图像分类模型训练有许多限制,而现在ML.NET模型建置器可以方便地以Azure云端资源训练模型
训练资料不足!?Google开源先进自然语言处理预训练技术BERT
BERT在史丹佛问答资料集SQuADv1.1获得新高分,准确度达93.2%,超过之前的最高分91.6%和人类91.2%。
训练资料不足不用愁!Google开源先进自然语言处理预训练技术BERT
BERT在史丹佛问答资料集SQuAD v1.1获得新高分,准确度达93.2%,超过之前的最高分91.6%和人类91.2%。
特斯联 NLP 自训练学习算法:降低人工参与,让机器“听得到”更“听得懂”
自然语言处理(NaturalLanguageProcessing,NLP)是计算机科学领域与人工智能领域中的一个重要方向,广泛应用于机器翻译、舆情监测、观点提取、语音识别等场景。自然语言处理技术在发展
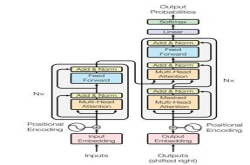
专栏|基于IR-transformer、IRGAN模型 解读搜狗语义匹配技术
机器之心专栏 搜狗搜索 NLP 本文介绍了搜狗搜索的 IR-transformer 模型和 IRGAN 强化学习训练框架。 摘要 搜索引擎作为上网冲浪的直接入口,其检索...
百度智能云VideoMind开放,你想要的模型训练平…
近期,百度智能云宣布开放业内第一个视频AI模型自动化生产平台VideoMind,可以帮助企业构建符合自身...
华为云ModelArts等你体验!128块GPU,ImageNet…
摘要:ModelArts实现了更少资源、更低成本、更快速度、更极致的体验。128块GPU,ImageNet训练时间从...
【re:Invent2018】加速企业打造ML模型,AWS机器学习工具SageMaker平台新增多项新功能
AWS近日一口气宣布在ML自动建置和部署工具SageMaker的平台中,推出多项新功能,包含语义分割算法、搜寻ML训练模型的功能Search,以及自动优化ML模型编译器Neo
字节跳动开源大模型训练框架 veGiantModel ,性能最高提升 6.9 倍
近日,字节跳动应用机器学习团队开源了一款名为veGiantModel的大模型训练框架,该训练框架主要应用于自然语言处理领域的大模型训练,最高可将大模型训练的性能提升6.9倍,大幅降低训练系统的压力。目
阿里达摩院发布全球最大 AI 预训练模型 M6:参数跃迁至 10 万亿
最新11月8日消息,今天,阿里巴巴达摩院公布多模态大模型M6最新进展,其参数已从万亿跃迁至10万亿,成为全球最大的AI预训练模型。M6是达摩院研发的通用性人工智能大模型,拥有多模态、多任务能力,尤其擅
ChatGPT 低成本复现流程开源,任意单张消费级显卡可体验
首个开源的ChatGPT低成本复现流程来了!预训练、奖励模型训练、强化学习训练,一次性打通。最小demo训练流程仅需1.62GB显存,随便一张消费级显卡都能满足了。单卡模型容量最多提升10.3倍。相比
2023-02-24 资讯 我要分享