AI2开源AstaBrief 8B:51秒生成带引用的科学报告
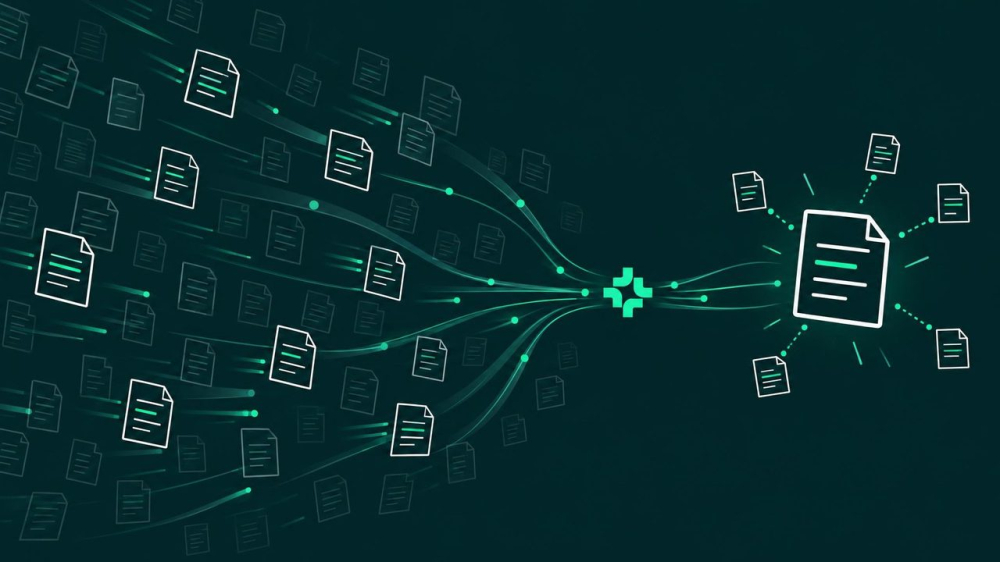
艾伦人工智能研究所(Allen Institute for AI,Ai2)10月2日宣布开源AstaBrief 8B,一个专门训练来写科学文献报告的小模型。它接收「研究问题+已检索到的文献片段」两项输入,一次性输出一篇带引用的完整报告,权重与训练数据以Apache 2.0协议全部公开,托管在Hugging Face上。该模型已作为「Fast模式」上线Ai2的科研智能体平台Asta,与原有的Claude驱动「Thinking模式」并列。
速度是它最直观的卖点。Ai2给出的全流程数据显示,Fast模式平均51.1秒生成一篇报告,而Claude驱动的Thinking模式平均要178.5秒,快了约3.5倍。Ai2称报告质量与其此前使用的专有模型组合相当,不过也坦承训练与评测大多在2025年完成,尚未与当前最新的前沿模型复测,用户应对生成引用自行核对。
训练路线走的是「监督微调+直接偏好优化(DPO)」而非强化学习,理由是RL训练不稳定且成本高。数据来自ScholarQA系统的真实用户查询:过滤掉测试、机器人、过短、非英文和非科研请求后留下约9万条;监督阶段的目标报告由Claude 3.5/3.7 Sonnet、o3、o4-mini、GPT-4.1等多模型流水线生成,精选出4.7万条;DPO阶段则用GPT-4.1与DeepSeek-R1双裁判从成对报告中择优,裁判与人类偏好一致率约95%,最终留下约6千个偏好对。
架构上的提速来自「砍流程」:Thinking模式要先做片段摘要与聚类、再分节写作,AstaBrief则根据问题与文献摘录一口气写完全文,省去了中间多级流水线。也就是说,3.5倍的加速一半来自模型、一半来自系统设计。
开源的实际意义在于部署自由:高校和企业可以在自己的硬件甚至内网防火墙之后跑这个8B模型,让涉及敏感数据或未发表成果的文献调研不出本地。Ai2同时在GitHub发布了示例工作流,研究者可以用它处理自己的PDF文献。对小模型专用化这个方向来说,这是一个值得参考的样本:用数据工程换取单个任务上接近大流水线的质量。
编译自 Ai2 Blog,原标题:"Open-sourcing AstaBrief, the fast report-generation model in Asta"