NASA与IBM开源月球基础模型 17年数据炼成
美国航天局(NASA)与IBM研究中心联合多所学术机构,正式发布开源的「NASA-IBM月球基础模型」(Lunar Foundation Model)。双方称这是最早一批专门面向月球科学的开源基础模型,目标只有一个:把NASA几十年攒下的海量月球观测数据,变成科研人员真正用得起来的机器学习底座。
训练语料名为SomBench,号称迄今最大的多模态月球对齐数据集:近200万个瓦片样本、覆盖11种模态和两级空间分辨率,其中约100万张来自窄角相机、分辨率约1米/像素的高清图像,另有96万余张宽角相机100米/像素的多光谱图像。数据主体来自月球勘测轨道飞行器(LRO)长达17年的观测,并补充了GRAIL的重力场、Lunar Prospector的氢含量分布以及日本月女神探测器的矿物数据,共整合9台仪器、4次任务、30多个空间对齐数据层。
架构上,团队以IBM与欧洲航天局等合作研发的地球观测模型TerraMind为基础,但选择了从零训练。一个关键设计是把每块影像的成像几何——入射光照角度、太阳位置、瓦片范围——作为显式输入喂给模型,因为在月球上,光照条件对影像外观的影响远大于地表本身的性质,与其让模型从原始像素里「猜」光照,不如直接告诉它。FlexiViT技术则让同一个模型能适配不同影像块尺寸而无需重训。
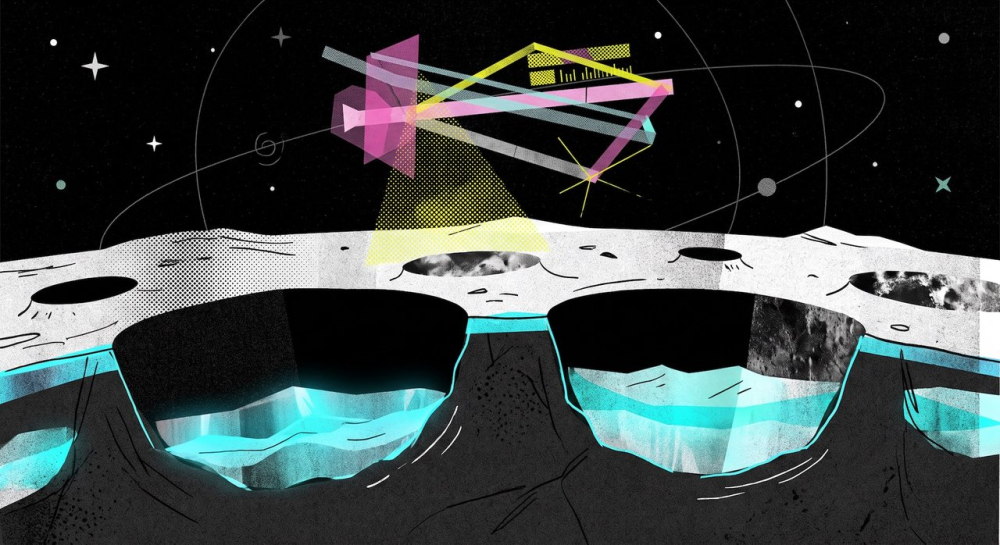
实测中,模型的优势最明显地体现在极地水冰预测上:与最强基线SwinV2-B相比,预测误差最多降低22%。永久阴影区极地陨石坑被视为未来登月任务潜在的水、氧气和火箭燃料来源,预测精度直接关系着陆点与钻探选址。粗尺度陨石坑检测上,模型领先基线近19%,而且只用了对手一半的标注数据,说明其少样本适应能力更强;在月海不规则斑块(IMP)分割等任务上则与最强基线大致持平。
研究者也坦承局限:模型并不适合绝对大地定位,生成测试中经纬度有时会偏差数十度;它是给下游科研任务用的分析底座,无法替代实地物理测量。部分测试集规模偏小,各创新点贡献的严格消融实验也还有待补做。
模型已上架Hugging Face,代码开源于GitHub并集成进开源工具链TerraTorch,ML就绪的预训练数据集和基准一并放出。这是NASA与IBM自2022年Space Act协议以来「AI for Science」合作的延续——2023年双方曾发布气候研究模型Prithvi,此次的月球模型是该家族针对深空场景的新成员。
编译自 The Decoder,原标题:"NASA and IBM's open source lunar model turns 17 years of orbiter data into a foundation for lunar science"