iPhone外接Mac跑大模型 预填充最高提速44%
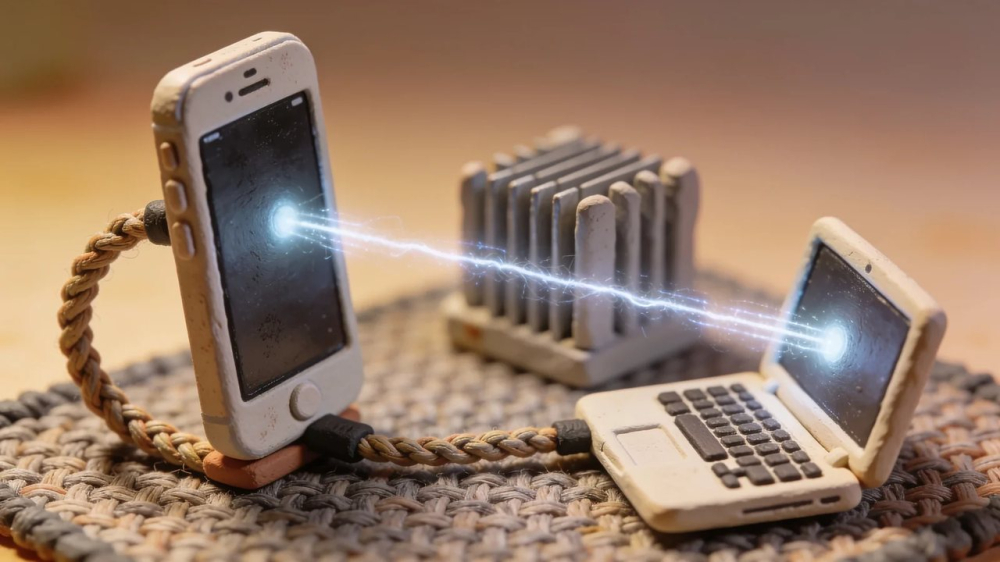
在 M4 Pro 版 MacBook Pro 上本地运行 Qwen3.8-27B 这类开源模型时,24GB 统一内存很快就成为瓶颈。一名 Reddit 用户想出的办法相当直接:用 USB-C 线把 iPhone 17 Pro Max 接到电脑上,再借助自己写的开源软件,让手机充当「第二块 GPU」。实测中,这套方案把长上下文场景下的预填充速度最多提升了 44%。
这名网友把模型的 64 层网络拆成两段做流水线并行:MacBook Pro 负责每一批 256 个 token 中的第 1 至 40 层,算完就把激活值通过 10Gbps 带宽的 USB-C 接口传给手机;iPhone 端用 A19 Pro 的 GPU 跑完剩下的第 41 至 64 层,而此时 Mac 已经开始处理下一批数据,两台设备全程没有空闲等待。依靠 GPU 矩阵运算,手机端的处理速度比不用 GPU 时快约 2.4 倍。
A19 Pro 的神经网络引擎也没有闲着。方案会把每 16K 长度的旧上下文编译成一套神经网络引擎模型,把键值当作权重;在 140K 上下文长度下,单 token 写入耗时从 279 毫秒降到 176 毫秒。
具体到「把一份 2000 token 的文件预填充并保存会话」这类智能体最常见的读取任务:上下文设为 8K 时,仅靠 Mac 是每秒 132 个 token,外接手机后达到 177 个,提升 35%;16K 上下文从 109 涨到 157,增幅 44%;32K 上下文从 101 涨到 130,提升 29%。上下文容量也被一同撑大——24GB 的 Mac 原本只能塞下 64K 的 8bit 上下文,接上手机后按手机空闲内存动态扩展,可以到 196K 至 229K,作者实测端到端跑通了 128K。
限制同样写得明白:在 64K 上下文以内,手机并不会加速文本生成,解码仍然全部由 Mac 完成,所以这套方案提速的是「读」,不是「写」。作者还提醒,屏幕上显示的每秒 token 数只覆盖手机持有的那部分层,评估时应该看端到端耗时——一场 26849 token 的冷启动智能体会话,原版 llama.cpp 跑 245 秒,只用 Mac 的分支 228 秒,接上手机后 168 秒。
这套软件名为 Backburner,已在 GitHub 以 MIT 协议开源。它是一个 llama.cpp 分支,加入了 SME2 与 Metal 算子融合,以及一个叫 DFlash2 的投机草稿模型;作者还用搭载 A18 Pro 的 iPhone 16 Pro Max 做过验证。在内存涨价、显存吃紧的当下,把口袋里闲置的算力调度起来,为本地大模型提供了一条务实路线。
编译自 Wccftech,原标题:"An iPhone 17 Pro Max Connected To An M4 Pro MacBook Pro Combined With Custom Software Resulted In Up To 44% Prefill Speeds When Running A 27B AI Model"