英伟达发布Minerva 预警AI工厂故障
AI工厂规模越大,故障排查就越像大海捞针。英伟达10月22日发布AIOps平台Minerva,专门为AI数据中心打造端到端的可观测能力:把基础设施和AI负载的遥测数据整合到一起,用AI模型提前发现问题,让GPU尽量少停机、多产出。
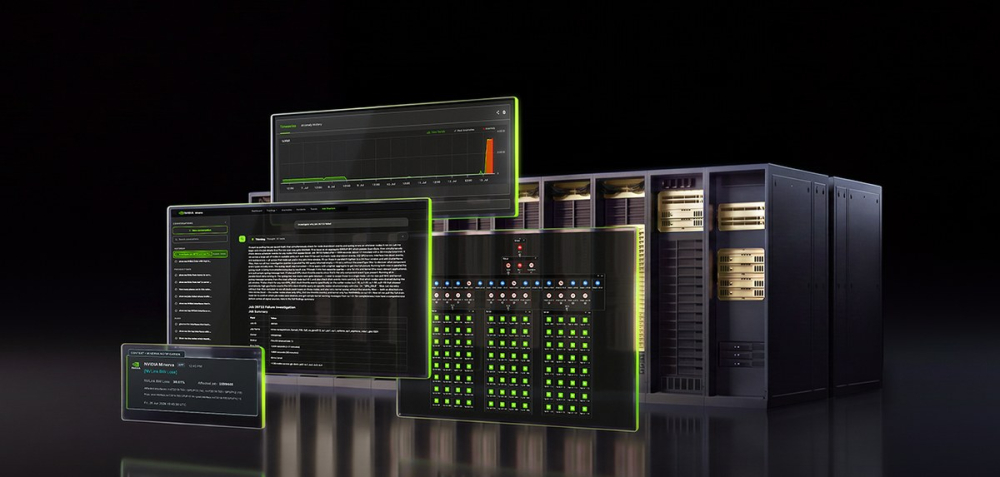
一个由数十万块GPU组成的训练集群里,任何一块组件性能劣化都可能拖慢整个任务,而预警信号往往非常隐蔽——比如某块GPU比同伴温度偏高,或某块NVMe固态盘在高负载下速度下滑。传统监控工具还把数据中心切成几块互不相通的视图,网络、计算、运维和机器学习团队各看各的,很难拼出全貌。
Minerva的思路是把信号全部接进来:GPU、Spectrum-X以太网、NVLink交换机、SuperNIC、DPU、Slurm和Run:ai等调度器以及AI负载的遥测数据统一汇聚,再用动态知识图谱把基础设施和正在运行的任务实时对应起来,帮助运维人员把一个变慢的训练任务直接定位到具体组件。平台每小时分析数十亿个数据点,学习系统的正常行为,识别从未见过的异常,并结合集群拓扑把相关事件归并成带疑似根因的单个事件,而不是把一堆症状一股脑推给运维。
平台内置名为Sherlock的多智能体助手,并支持通过MCP协议接入外部AI工具,运维人员可以用自然语言排查集群健康状态、获取修复建议,再由人工执行或通过基础设施API自动完成。英伟达称内部测试中,一次NVMe供电故障的平均修复时间从数天缩短到6小时,81条告警噪音被合并成1条,省下了54小时的集群运行时间;不过公司并未给出承诺性的量化指标。
云厂商IREN已在用Minerva优化自己的AI工厂,其首席技术官表示统一视图让团队得以从被动救火转向主动维护。Aolani、Bitdeer AI、IBM、Jio、Lambda、Quake AI和特斯拉计划部署,戴尔、联想和超微将把Minerva纳入各自的AI工厂运维方案。该平台属于英伟达Vera Rubin平台全栈的一部分,可本地部署或以SaaS方式交付,最高可扩展到数十万块GPU规模。
编译自 NVIDIA官方博客,原标题:"NVIDIA Unveils Minerva to Bring End-to-End Observability for AI Factories"