纯CPU跑2.8万亿参数模型 靠二手傲腾
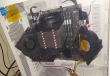
一位搭建家用推理环境的玩家近日在 Reddit 的 homelab 版块晒出一套方案:不装显卡,靠二手英特尔傲腾持久内存(Optane PMem 200)和一颗40核第三代至强可扩展处理器,跑起了月之暗面的2.8万亿参数模型 Kimi K3。
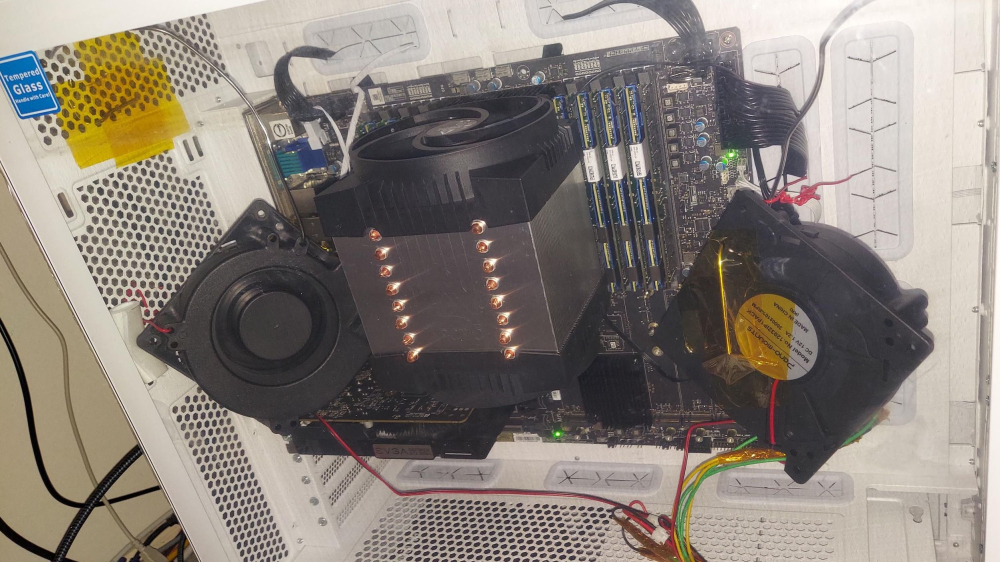
Kimi K3 显然不是为家用准备的。官方建议使用数据中心的推理引擎,即便最小的社区量化版本也需要至少610GB内存。在DRAM价格一路飙升的当下,二手傲腾成了少数能在家里凑出这个容量的途径,玩家称其成本只有同等容量内存的“零头”。
傲腾 PMem 200 于2020年随第三代至强发布,单条容量有128GB、256GB、512GB三档,在双路平台上有效传输速率高于第一代,平均内存带宽最多高出约三成。本次搭建采用的是应用直连模式(App Direct),把傲腾作为独立的持久区域交给软件直接映射,按玩家的说法,这样能更精确地控制模型张量放在哪里。
代价是速度。1比特量化下生成速度只有每秒0.85个词元,换成3比特量化进一步降到每秒0.75个。有评论者算了一笔账:一个5万词元的任务按这个速度要跑13个小时。不过这些数字是未调优状态下的结果,线程数和NUMA亲和性都还没动。
更难缠的是散热。每根傲腾模组功耗12瓦到15瓦,四根并排就有最高60瓦的热量紧贴系统内存,持续推理时模组“极热”,玩家警告这可能烤坏旁边的DRAM。英特尔规格要求每秒2.4米至2.7米的强制风冷,这基本是机房工况;玩家在机箱里加了两只12瓦涡轮风扇才把温度压住,并建议“把主动DIMM散热当成必需品”。
这已经是该系列的第二版方案。上一版用第一代傲腾、内存模式,并让一块 RTX 3060 分担部分计算,以2比特量化跑1万亿参数的 K2.5,速度约为每秒4个词元。新方案规模更大、也更纯粹,但速度回落到不足每秒1个词元。
玩家表示后续还会加装显卡,并把部分专家层放进DRAM做成高速层,更多测试数据尚未公布。对想在家折腾超大模型的爱好者来说,这套方案的实际意义可能不在速度,而在于证明了二手企业级硬件仍有一条可行的路。
编译自 Tom's Hardware,原标题:“Homelabber uses second-gen Optane memory sticks to run a 2.8-trillion-parameter AI model on CPU alone”