比CPU快24倍 看小米如何依托GPU快速构建AI能力
智东西(公众号:zhidxcom)文 | 司马特近期小米官方宣布,截止到7月底,小米AI助理小爱同学月活跃设备超过3000万台,今年7月小爱同学唤醒超10亿次,累计唤醒...

六大门派,围攻云端 AI 芯片光明顶
AI芯片的战场,明显更热闹了。就在上周五,国际权威人工智能(AI)性能基准测试MLPerf公布了最新的数据中心及边缘场景AI推理榜单结果,无论是参与评选的企业还是实际AI芯片表现,都比往届多了不少看头
2022-12-21 资讯 我要分享
脸书开源服务器端推理函式库FBGEMM,以低精度运算加速机器学习推理
与科学计算中使用的传统线性代数函式库不同,FBGEMM不使用FP32或FP64精度,而是透过降低精度计算以加速深度学习模型。
MLPerf 最新发榜,浪潮 AI 服务器囊括数据中心推理全部冠军
2022年4月7日,全球权威AI基准评测MLPerf™公布最新AI推理(Inference)V2.0榜单,浪潮AI服务器以最高性能获得了数据中心(固定任务)的全部16项冠军。MLPerf™由图灵奖得主
英伟达Vera Rubin系统投产 推理吞吐提升4.8倍
英伟达新一代VeraRubinNVL72系统已在CoreWeave云平台投入生产,AI软件公司Cognition成为首个运行生产负载的客户,软件工程推理任务的总token吞吐量较上一代GB200NVL
2026-10-04 科技 我要分享微软用ONNX Runtime加速IntelliCode整行程式码完成模型推理
微软利用ONNX Runtime将程式码完成模型部署到客户端,经过最佳化后,内存使用率和效能都获得大幅提升
英伟达 TensorRT 8 上线,BERT 推理延迟仅有 1…
英伟达昨日发布了其 TensorRT 的 8.0 版本。TensorRT 可以看作是在英伟达各种 GPU 硬件平台下运行的...
机器学习推理引擎ONNX Runtime 1.8开始支援网页AI用例
ONNX Runtime 1.8加入网页支援,可以在浏览器中使用CPU和GPU来加速模型运算
超越苹果 M1,OpenCV 4.7 在华为昇腾架构下仅 3.29ms 完成 ResNet50 推理
最新1月18日消息,英特尔开源计算机视觉库OpenCV4.7于去年12月正式发布。新版本带来了全新的ONNX层,大大提高了DNN代码的卷积性能,还为DNN模块提供了华为昇腾CANN后端支持。根据Ope
2023-02-12 资讯 我要分享英伟达 CV-CUDA 高性能图像处理加速库 Alpha 版本发布 ,并在 GitHub 上开源
最新12月21日消息,英伟达宣布,CV-CUDA(ComputerVision-ComputeUnifiedDeviceArchitecture)高性能图像处理加速库,近日发布Alpha版本,正式向全
2023-01-05 资讯 我要分享TensorFlow采用OpenCL后端使GPU推理效能加倍
OpenCL的设计更适合用于各种计算加速器,因此以OpenCL后端处理行动装置GPU推理工作负载,比OpenGL后端效能好上许多
Google更新XNNPACK加速函式库强化稀疏模型支援
开发者可以使用XNNPACK加速函式库和TensorFlow Lite框架创建稀疏模型,来缩小模型大小,并且加快模型在CPU上的推理速度
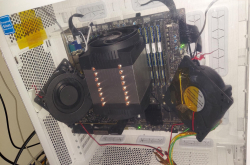
纯CPU跑2.8万亿参数模型 靠二手傲腾
一位玩家用二手英特尔傲腾持久内存,在纯CPU平台上跑起2.8万亿参数的KimiK3大模型,速度仅每秒0.85个词元,还得靠两只涡轮风扇压住每根12瓦模组的热量,否则可能烤坏旁边内存。
2026-11-09 科技 我要分享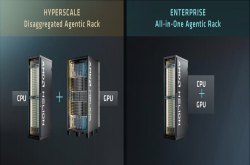
AMD发布Helion机架 单柜最高32768核心
AMD在OCP全球峰会发布面向代理式AI的机架参考设计Helion:ORv4规范、44个OpenU托盘、风冷或液冷,纯CPU版单柜最多128颗256核EPYCVenice、约32768个Zen6核心,
2026-10-13 科技 我要分享荔枝音质高保真的降噪技术实践与研究
当前直播行业愈发火热,用户通常处于不同的环境中,身边的键盘声,敲击声,空调声,喧哗声等噪声有时会对实时互动产生严重的干扰。然而传统的降噪算法针对平稳噪声有比较好的降噪效果,针对上述这一类非平稳噪声,比
2022-09-13 资讯 我要分享