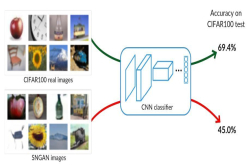
不再使用人眼评估 你训练的GAN还OK吗?
选自arXiv 作者:Konstantin Shmelkov等 机器之心编译 参与:李诗萌、张倩 生成对抗网络(GAN)是当今最流行的图像生成方法之一,但评估和比较 GAN 产生的...

生成式 AI 火了:硅谷押注,让你把简单文字变成图像甚至视频
10月9日消息,最近几年兴起的所谓"生成式人工智能(generativeAI)"正吸引硅谷科技巨头和风投机构的兴趣,这种AI可以依据少量词汇在几秒钟内生成与之相匹配的图像。分析师预计,这种技术将被广泛
2022-12-21 资讯 我要分享Jay Alammar 再发新作:超高质量图解 Stable Diffusion ,看完彻底搞懂「图像生成」原理
小白都能看懂的StableDiffusion原理!还记得火爆全网的图解Transformer吗?最近这位大佬博主JayAlammar在博客上对大火的StableDiffusion模型也撰写了一篇图解,
2023-02-12 资讯 我要分享英伟达超快 StyleGAN 回归,比 Stable Diffusion 快 30 多倍,网友:GAN 好像只剩下快了
扩散模型的图像生成统治地位,终于要被GAN夺回了?就在大伙儿喜迎新年之际,英伟达一群科学家悄悄给StyleGAN系列做了个升级,变出个PLUS版的StyleGAN-T,一下子在网上火了。无论是在星云爆
2023-02-12 资讯 我要分享Google应用扩散模型拉高照片分辨率,人类难区分合成与真实照片
Google最新的超分辨率研究,透过使用超分辨率扩散模型,可以从低分辨率图像生成逼真高分辨率的图像,连人类也难以分辨合成图像与相片
声网 Agora Lipsync 技术揭秘:通过实时语音驱动人像模拟真人说话
元宇宙的火热让人们对未来虚拟世界的形态充满了幻想,此前我们为大家揭秘了声网自研的3D空间音频技术如何在虚拟世界中完美模拟现实听觉体验,增加玩家沉浸感。今天我们暂时离开元宇宙,回到现实世界,来聊聊声网自
2022-07-13 资讯 我要分享声网 Agora Lipsync 技术揭秘:通过实时语音驱动人像模拟真人说话
元宇宙的火热让人们对未来虚拟世界的形态充满了幻想,此前我们为大家揭秘了声网自研的3D空间音频技术如何在虚拟世界中完美模拟现实听觉体验,增加玩家沉浸感。今天我们暂时离开元宇宙,回到现实世界,来聊聊声网自
各路 StyleGAN 大汇总,包括全景图生成、图像到图像翻译等
StyleGAN在各种图像处理和编辑任务上,表现很惊艳。然而,"干一种活"就得换个体系重新"培训"一次,太麻烦。终于,有人细细研究了一下,发现:其实只通过预训练和潜空间上的一点小操作,就可以让Styl
OPPO 公开 3D 照片生成专利,仅需一张待处理图像即可快速生成
IT之家10月30日消息,昨日,OPPO广东移动通信有限公司公开"3D照片的生成方法与装置、终端及可读存储介质"专利,公开号为CN113570702A。企查查专利摘要显示,本申请的3D照片的生成方法、
苹果开发出“AI 建筑师”GAUDI,可根据文本生成超逼真 3D 场景
如今,每隔一段时间就有新的文本生成图像模型释出,个个效果都很强大,每每惊艳众人,这个领域已经是卷上天了。不过,像OpenAI的DALL-E2或谷歌的Imagen等AI系统,都只能生成二维图像,如果文字
2022-09-13 资讯 我要分享
告别街景拍摄车?机器学习可根据卫星图像描绘地面
编者按:来自加州大学默塞德分校的邓薛庆和他的同事们研究出一项新技术,能根据卫星图像描绘出该地区的地面视图,这将大大减轻地理学家的工作强度。本文经授...
OpenAI 文本生成图像工具 DALL-E 取消排队,任何人均可立即使用
最新9月29日消息,OpenAI已经取消了访问其文本生成图像系统DALL-E2的等待名单,这意味着任何人都可以立即注册使用这个人工智能艺术生成器。该公司在2021年1月发布了初代DALL-E,该工具以
2022-12-21 资讯 我要分享2022 生成模型进展有多快,新论文盘点 9 类生成模型代表作
ChatGPT的出现,彻底将生成AI推向爆发。但别忘了,AI生成模型可不止ChatGPT一个,光是基于文本输入的就有7种--图像、视频、代码、3D模型、音频、文本、科学知识……尤其2022年,效果好的
2023-02-12 资讯 我要分享北大和微软亚研院开发出 AI 模型“女娲”:可完成图像补全、一句话生成视频等八种视觉任务
有这样一个模型,它可以做到一句话生成视频:不仅零样本就能搞定,性能还直达SOTA。它的名字,叫"NüWA"(女娲)。"女娲女娲,神通广大",正如其名,一句话生成视频只是这个模型的技能之一。除此之外,一
字节跳动最新文本生成图像 AI,训练集里居然没有一张带文字描述的图片?!
一个文本-图像对数据都不用,也能让AI学会看文作图?来自字节的最新text2image模型,就做到了。实验数据显示,它的效果比VQGAN-CLIP要真实,尤其是泛化能力还比不少用大量文本-图像数据对训
这些资源你肯定需要 超全的GANPyTorch+Keras实现集合
选自GitHub 作者:eriklindernoren 机器之心编译 参与:刘晓坤、思源、李泽南 生成对抗网络一直是非常美妙且高效的方法,自 14 年 Ian Goodfellow 等...
英伟达从图像中抽象出概念再生成新的图像,网友:人类幼崽这个技能 AI 终于学会了
人类幼崽2岁就能做的事,AI竟然才学会?早在2017年,就有网友吐槽:2岁幼童只要见过一次犀牛的照片,就能在其他图片里认出不同姿势、视角和风格的卡通犀牛,但AI却做不到。直到现在,这一点终于被科学家攻
2022-09-13 资讯 我要分享