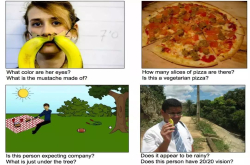
这个深度学习库能执行 10 多种图像文本任务,有 20 多个数据集,还统一接口|已开源
支持10余种图像文本任务,囊括20多种数据集,还提供SOTA模型性能和可复现预训练及微调实验配置。没错,这是一个视觉语言深度学习框架就可以拥有的。这个库的庐山真面目是:Salesforce亚洲研究院推
2022-12-21 资讯 我要分享
教 ChatGPT 学会看图的方法来了
2022年流行"文生图"模型,那2023年流行什么?机器学习工程师DanielBourke的答案是:反过来!这不,一个最新发布的"图生文"模型在网上爆火,其优秀的效果引发众多网友纷纷转发、点赞。不仅是
2023-02-12 资讯 我要分享特斯联 AI 研发突破(1):基于语义对齐多级表征学习的指定视频目标分割
图像分割技术是计算机视觉领域的重要研究方向,也是该领域其他应用的一个重要前期步骤。近些年来,随着深度学习技术的逐步深入,图像分割技术有了突飞猛进的发展,尤其在场景物体分割、人体背景分割、三维重建等技术
2022-12-19 资讯 我要分享AI趋势周报第97期:AI向下扎根!教育部推出中小学AI教材
配合108学年度新课纲,教育部释出适合中小学的AI教案《和AI做朋友吧》电子版,预计9月提供线上AI教师培育班,12月将举办教师工作坊。
谷歌发布最新看图说话模型:可实现零样本学习,多类型任务也能直接上手
谷歌新推出了弱监督看图说话模型SimVLM,能够轻松实现零样本学习(zero-shot)任务迁移。从文字描述图像到回答图片相关问题,模型无需微调也能样样精通。对于一般的视觉语言预训练(VLP)模型,训
不做文盲画家,谷歌魔改「文本编码器」:一个小操作让图像生成模型学会「拼写」
图像生成模型终于学会了拼写单词,秘诀竟是字符特征?过去的一年里,随着DALL-E2,StableDiffusion等图像生成模型的发布,text-to-image模型生成的图像在分辨率、质量、文本忠实
2023-02-12 资讯 我要分享
微软Azure影片索引器正式上线,新加入情绪侦测、语言辨识模型,自动判别讲者情绪及使用语言
现在影片索引服务变得更聪明,即使影片中未出现关键字,根据影片的演说情境、视觉提示等资料,系统也能辨别该影片的议题、内容
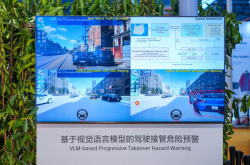
索尼全球首发VLM驾驶接管预警
索尼11月5日在第九届进博会全球首发基于视觉语言模型的驾驶接管危险预警技术,通过分析前方道路画面判断是否接近或超出智驾系统设计运行范围,提供三级接管提示,目前已与清华汽车工程学院在苏州开展实路测试。
2026-11-08 科技 我要分享DeepMind 两年研究一朝公开,通用人工智能最新突破:一个模型、一套权重通吃 600 + 视觉文本和决策任务
感谢最新网友Sancu的线索投递!通用人工智能,还得看DeepMind。这回,只一个模型,使用相同的权重,不仅把看家本领雅达利游戏玩得飞起。和人类聊聊天、看图写话也不在话下。甚至还能在现实环境里控制机
2022-12-19 资讯 我要分享