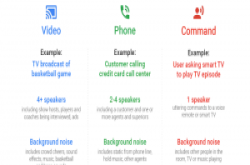
Google为影片、电话和虚拟助理量身打造语音辨识模型,提高语音转文字准确性
Google最近更新了语音转文字的服务,为影片、电话和虚拟助理的语音互动模式,打造专属的语音辨识模型,要让语音转文字服务更加准确,此外,还加入了自动下标点符号的功能

Google发布用于自动语音辨识的资料增强新方法
Google的语音资料增强新方法SpecAugment,是直接对声学音谱图输入资料进行增强,不需要额外的资料,同时还能有效地改善自动语音辨识模型的效能
Google直接在手机部署机器学习模型,离线也能使用语音输入文字
传统语音辨识引擎使用的模型过于庞大,无法放在行动装置上,Google参数化模型并在最佳化之后,能压缩模型到只剩80MB
微软发布最新智能语音合成模型 Uni-TTSv3:一音色多语言,高保真高效率
最新11月16日消息,日前,微软发布最新Azure神经网络语音合成技术Uni-TTSv3多语言语音合成模型。与上一代语音合成模型相比,Uni-TTSv3语音合成保真度更高、速度更快、训练时间更短,更降
火山语音 7 篇论文入选国际顶会 Interspeech
日前,火山语音团队七篇论文成功入选国际顶会Interspeech2022,内容涵盖音频合成、音频理解等多个技术方向的创新突破。Interspeech作为国际语音通信协会ISCA组织的语音研究领域的顶级
2022-12-21 资讯 我要分享Google AI语音服务大更新,不仅降价还新增7种语言和31种声音
为了扩展AI语音服务的市场,Google除了加强语音辨识模型、语言支援数量和声音种类之外,也调整了语音服务的价格
更轻,但更好!科大讯飞首发工业级中文预训练模型
近年来,以超大规模模型、海量训练数据、自监督学习准则为特点的无监督预训练模型备受关注。具有高通用性的无监督预训练大模型,结合知识和海量数据进行融合学习,通过提取原始数据的深层表征,实现对于下游任务的通
2023-01-06 资讯 我要分享Google发布端到端语音翻译模型,还能保留原本的声音特征
Translatotron模型透过单一的注意力Seq2seq网络,能直接将语音翻译成另一种语言的语音,中间不需要借助文字资料的转换
Google改良语音过滤模型,提升装置上语音辨识效果
轻量级语音过滤模型VoiceFilter-Lite,能够在装置上高效能运作,不需要网络连线,就能良好辨识目标使用者的声音,以改善语音辨识的效果
直接开源,阿里达摩院公布下一代工业级语音识别模型
最新12月22日消息,阿里巴巴达摩院今日发布了新一代语音识别模型Paraformer,适用于语音输入法、智能客服、车载导航、会议纪要等场景。据介绍,这是业界首个应用落地的非自回归端到端语音识别模型,在
2023-01-05 资讯 我要分享
脸书发布高效能完全非监督式语音辨识模型Wav2vec-U
Wav2vec-U是脸书Wav2vec语音辨识模型的非监督式版本,完全不需要转录资料,也不用标签资料训练,效能已经与2019年最佳监督式语音辨识模型相当
AWS用新方法改良自然语言模型,让Alexa语音辨识错误率降低15%
正确理解用户所说的话,是语音助理服务致胜的关键,AWS最近透过新方法来改良自然语言模型,使Alexa的语音辨识错误率降低15%
阿里达摩院开源语音识别模型DFSMN 准确率达96.04%
Amoy 发自 凹非寺量子位 报道 | 公众号 QbitAI阿里巴巴达摩院又有新开源模型,这次是语音识别模型DFSMN。近日,阿里达摩院机器智能实验室开源了新一代语音识...